目次
概要
MLOpsの背景と専用Model Servingの必要性
- 現代の人工知能の時代において、研究室で高い精度を達成した機械学習(Machine Learning - ML)モデルと、本番環境(Production)で安定して稼働するAIシステムの間には、非常に大きな隔たりがあります。この受け渡し段階は一般に「Model Serving」または「Inference Serving」と呼ばれ、レイテンシ(latency)、スループット(throughput)、スケーラビリティ(scalability)に関する深刻な技術的課題を突きつけます。
- NVIDIA Triton Inference Server(旧称 TensorRT Inference Server)は、この課題を解決する業界標準のソリューションとして登場しました。Tritonは、モデルを載せる単なる「Webサーバー」ではありません。AI開発プロセス(AI Pipeline)の中心に位置する、複雑な計算管理ミドルウェアです。
- 標準的なMLOpsワークフローでは:
- Data Engineering: データの収集と処理。
- Model Training: PyTorch、TensorFlowなどのフレームワークを用いたモデルの学習。
- Model Optimization: モデルの最適化(例: 量子化、剪定、TensorRTへの変換)。
- Model Registry: モデルバージョンの管理。
- Model Serving(Tritonの位置): 予測を提供するためにモデルをデプロイ。
- Monitoring: 性能とデータドリフト(Drift)の監視。
Tritonは第5ステップにおける「高性能な橋渡し」として機能します。ステップ2または3で学習済みのモデルを受け取り、ハードウェア資源(GPU/CPU)を透過的に管理し、エンドユーザー側のクライアントアプリケーション向けに標準化されたAPIエンドポイントを提供します。
比較分析: Tritonと代替ソリューション
AIエンジニアがしばしば直面する重要なアーキテクチャ上の判断は、サーバーを自作するか(Build)、既存のソリューションを採用するか(Buy/Adopt)です。
TritonとFlask/FastAPIソリューションの比較
多くのチームは、PyTorch/TensorFlowモデルをFlaskまたはFastAPIのWebアプリケーションで包むところから始めます。このアプローチは初期導入は容易ですが、規模を拡大すると致命的な弱点が現れます。
- 推論性能が低い: PythonのWebフレームワークはGlobal Interpreter Lock(GIL)に制約され、真のマルチスレッド処理(true multi-threading)が制限されます。多数のリクエストが同時に到着すると、逐次処理されるか、非効率な並列処理になり、GPUがCPU側でボトルネックになります。
- GPUメモリ管理が弱い: Flask/FastAPIにはGPUメモリを管理するネイティブな仕組みがありません。複数のワーカーが同時にモデルをGPUへロードしようとすると、Out Of Memory(OOM)エラーが非常に起きやすくなります。
- 高度な機能の欠如: Dynamic Batching(リクエストの動的なまとめ)やModel Versioningなどの機能はゼロから自作する必要があり、時間を消費し、ロジックバグも生じやすくなります。
TritonとTorchServe、TensorFlow Servingの比較
TorchServeとTensorFlow Servingは専用のservingソリューションですが、多くの場合、それぞれのフレームワーク生態系に強く縛られます。
| 特性 | TensorFlow Serving | TorchServe | NVIDIA Triton Inference Server |
|---|---|---|---|
| Backendのサポート | TensorFlow(SavedModel)に最適化。 | PyTorch(TorchScript/Eager)に最適化。 | マルチフレームワーク: TensorRT、ONNX、PyTorch、TF、Python、OpenVINO、RAPIDS FIL。 |
| GPU性能 | TF上では良好。 | PyTorch上では良好。 | 非常に優秀。CUDA/CUDNNライブラリによる深い最適化、C++による直接的なメモリ管理。 |
| Pipeline/Ensemble | 限定的。 | workflows経由でサポート。 | 強力。DAG(Directed Acyclic Graph)とBusiness Logic Scripting(BLS)をサポート。 |
| Batchingの仕組み | あり。 | あり。 | Dynamic Batching。優先度付きスケジューリング(Priority Queuing)とタイムアウト制御付き。 |
| 複雑さ | 中程度。 | 中程度。 | 高い(丁寧な設定が必要ですが、その代わりに包括的な制御が可能です)。 |
なぜTritonを選ぶのか? 最も説得力のある理由はインフラの統一です。企業では、データサイエンスチームが複数の異なるフレームワークを使うことがあります。TorchServe用クラスタとTF Serving用クラスタを別々に維持する代わりに、Tritonはすべての種類のモデルを同一インスタンス上で実行でき、ハードウェアコストを最適化し、DevOpsプロセスを簡素化します。
Tritonの主な特徴
- Multi-Framework Support: 異なる形式のモデル(ONNX、TensorRT、PyTorch)を同一GPU上で同時に実行できます。Tritonはコンテキストスイッチ(context switching)を効率的に管理し、GPU Utilizationを最大化します。
- Dynamic Batching: スループット(Throughput)を高めるうえで最も重要な機能です。サーバーは複数クライアントからの散発的なリクエストを自動的に大きなバッチへまとめ、GPUへ送ります。大きなバッチでの行列計算は、単発の計算よりもはるかに効率的です。
- Concurrent Model Execution: Tritonは、同一モデル(または異なるモデル)の複数インスタンスを同一GPU上で並列実行(CUDA Streamsを使用)したり、複数GPUへ負荷分散したりできます。
- Model Ensembles & BLS: 複雑なパイプライン(前処理 → 推論 → 後処理)をサーバー上で構築でき、クライアントとサーバー間のデータ転送(Network Overhead)を削減します。
通信プロトコル: HTTP vs. gRPC
Tritonは両プロトコルでKServe標準をサポートします。
- HTTP/REST(ポート 8000):
- 特徴: JSON payloadを使用します。Web/JSアプリケーションとの統合が容易です。cURLやPostmanなどのツールでデバッグしやすいです。
- 制限: JSONのSerialization/Deserializationコストにより性能は低く、gRPCほど効率的な持続接続(persistent connection)はサポートしません。
- 推奨: 極めて低いレイテンシを求めないアプリケーション、または開発・テスト段階。
- gRPC(ポート 8001):
- 特徴: Protocol Buffers(バイナリ形式)を使用します。双方向ストリーミング、持続接続の維持、効率的なデータ圧縮をサポートします。
- 利点: 低レイテンシ、高帯域です。パケット順序を保証します(Speech-to-Textなどのstatefulモデルで重要です)。
- 推奨: Production環境、Microservices間通信、または入力が大きなデータ(高解像度画像、動画、音声)の場合。
アーキテクチャ概要
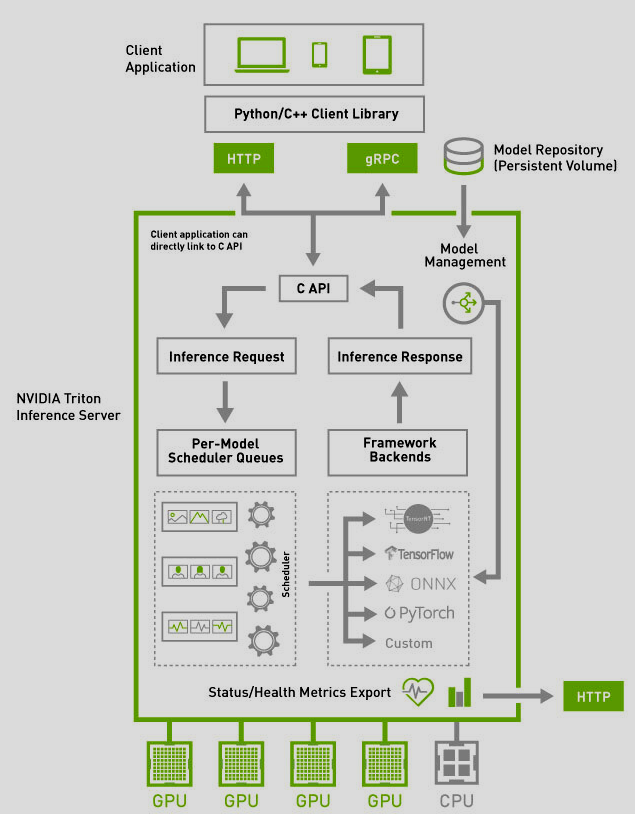
Triton Inference Serverは独立したサービスとして動作し、クライアントのリクエストはここに送られて推論処理が行われます。モデルの管理、クライアントからの推論リクエストの処理、そして可能な限り最適な性能で結果を返すことを担います。リクエストを受け取ると、TISは適切なモデルを選択し、入力データを処理して対応する結果を返します。TISはNVIDIAのチームにより、NVIDIAのグラフィックスカード上で最もよく、最も最適化されて動作するよう設計されています。Triton Inference Serverの主な構成要素は次のとおりです。
- Model Repository: Tritonがモデルを管理し、必要に応じてメモリへロードできるよう構成されたモデルを格納するディレクトリです。Model Repositoryにはモデルバージョンと設定ファイル(config.pbtxt)が含まれ、モデルの実行方法、input/outputの扱い、リソース要件を記述します。
- Scheduler: Tritonへ送られたリクエストを管理するコンポーネントです。Schedulerはリクエストをバッチにまとめ、処理時間を調整してレイテンシを最小化することで、リソース利用を最適化します。これにより、システムは過負荷にならずに多数のリクエストを同時に処理できます。
- Model Execution Backend: TISは推論を実行するために多くのbackendをサポートしており、TensorFlow、PyTorch、ONNX Runtime、TensorRTなどのプラットフォームが含まれます。各backendは対応する形式とフレームワークに従ってモデルを処理し、互換性と最高の性能を確保します。
- Inference API: TISはRESTとgRPCという2種類の主要なAPIを提供し、ユーザーはネットワーク経由でリモートから推論リクエストを送り、結果を受け取れます。これらのAPIは単一リクエストから一括処理まで多様なリクエスト種別をサポートし、大規模アプリケーションに適しています。
リクエストがTriton Inference Serverへ送られると、次のステップを経ます。
- ステップ1 APIからリクエストを受信: ユーザーはRESTまたはgRPC API経由で、モデルへの入力データとともにリクエストを送ります。
- ステップ2 モデルとバージョンの選択: Tritonはリクエストに基づいて適切なモデルを選択し、Model Repository内の稼働中バージョンを確認します
- ステップ3 Batchingによる最適化: 類似するリクエストが多数ある場合、Tritonはそれらをバッチにまとめて同時処理し、システムの負荷を下げ、処理速度を高めます。
- ステップ4 モデルの実行: モデル実行backendがデータバッチを受け取り、推論を実行し、入力データに基づく結果を返します。
- ステップ5 クライアントへ結果を返却: 推論が完了すると、TISはAPI経由でユーザーへ結果を返します。
Model repository
Triton Inference Server上で使用する各モデルは、Model Repository内で構成・整理されます。ここはモデルとその設定情報を保存する場所です。たとえばmodel.onnxファイルがあり、TIS上で動作させるための対応する設定が必要だとします。次の作業を行う必要があります。
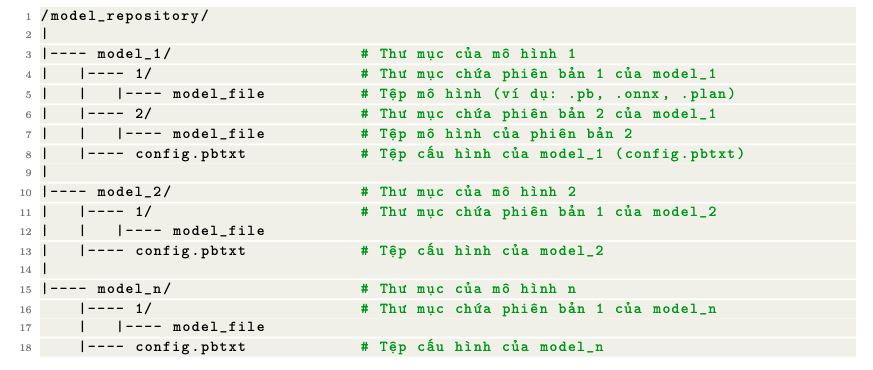
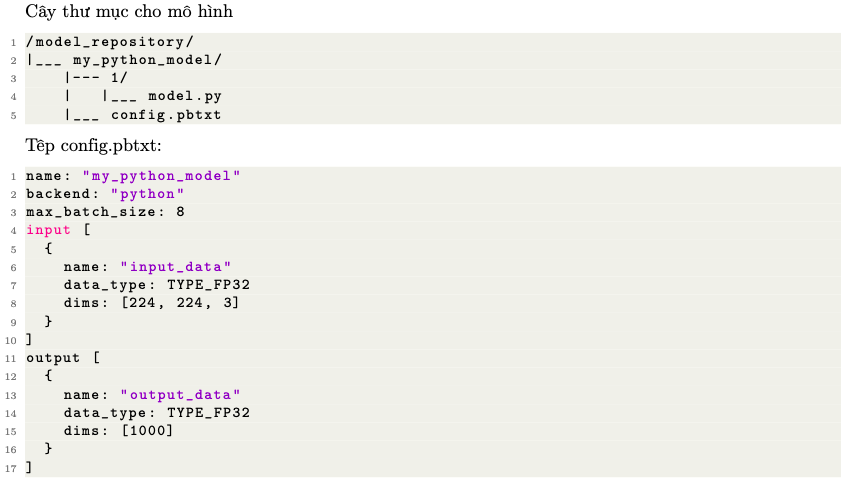
- モデル専用ディレクトリの作成: 各モデルは専用ディレクトリに置く必要があります。そのディレクトリには、少なくともメインのモデルファイルであるmodel.onnxと、設定ファイルconfig.pbtxtを含める必要があります。この設定ファイルでは、モデルのinput/output、最大バッチサイズ、モデルが処理できる最大concurrent requests数などの重要なパラメータを定義します。ディレクトリツリーは次の形式になります。
- config.pbtxtの設定: これはTIS内でモデルがどのように実行されるかを記述するprotobufファイルです。input/outputのデータ形式、batching、dynamic batching、その他の性能パラメータに関する情報を含みます。設定ファイルの例は次のとおりです。
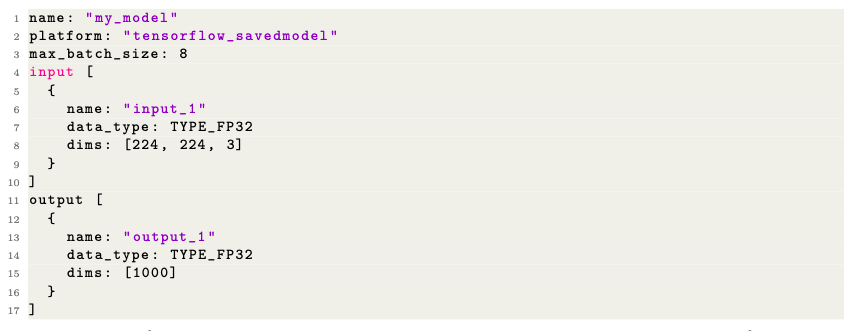
これはProtobuf Text形式のファイルで、Tritonの設計図(blueprint)として機能します。入力の形状(shape)は何か?データ型(datatype)はFP32かINT8か?CPUで動かすかGPUで動かすか?どのbackendを使うか?といった問いに答えます。このファイルがない場合、Tritonには設定を自動推論するStrict-Model-Config=Falseモードがありますが、Productionでは性能を制御するために明示的な定義が必須です
- その後、Triton Inference Serverをデプロイする際には、正しいディレクトリ位置を宣言する必要があります。TISはモデルを自動的にロードし、config.pbtxtで定義されたとおりに推論プロセスを初期化します。
Instance Groups
Instance Groupは、Tritonがメモリ内でモデルを複製し、多数のリクエストを同時に処理できるようにする概念です。
- Parallel Execution on GPU: デフォルトでは、TritonはGPUごとに1インスタンスを作成します。ただし、モデルが軽量(例: ResNet18)でGPUが強力(A100)な場合、1インスタンスではCUDA Coresを100%使い切れません。
countを増やすことで、モデルの複数コピーを作成します。これらのコピーはメモリ(weights)を共有しつつ、それぞれ独自の実行コンテキストを持ち、GPUが計算とデータ転送をオーバーラップ(overlap)して処理できるようにします。
instance_group [
  {
    count: 2
    kind: KIND_GPU
    gpus: [ 0, 1 ]
  }
]
以下は、Dynamic BatchingとConcurrent model executionの利用を示す図です
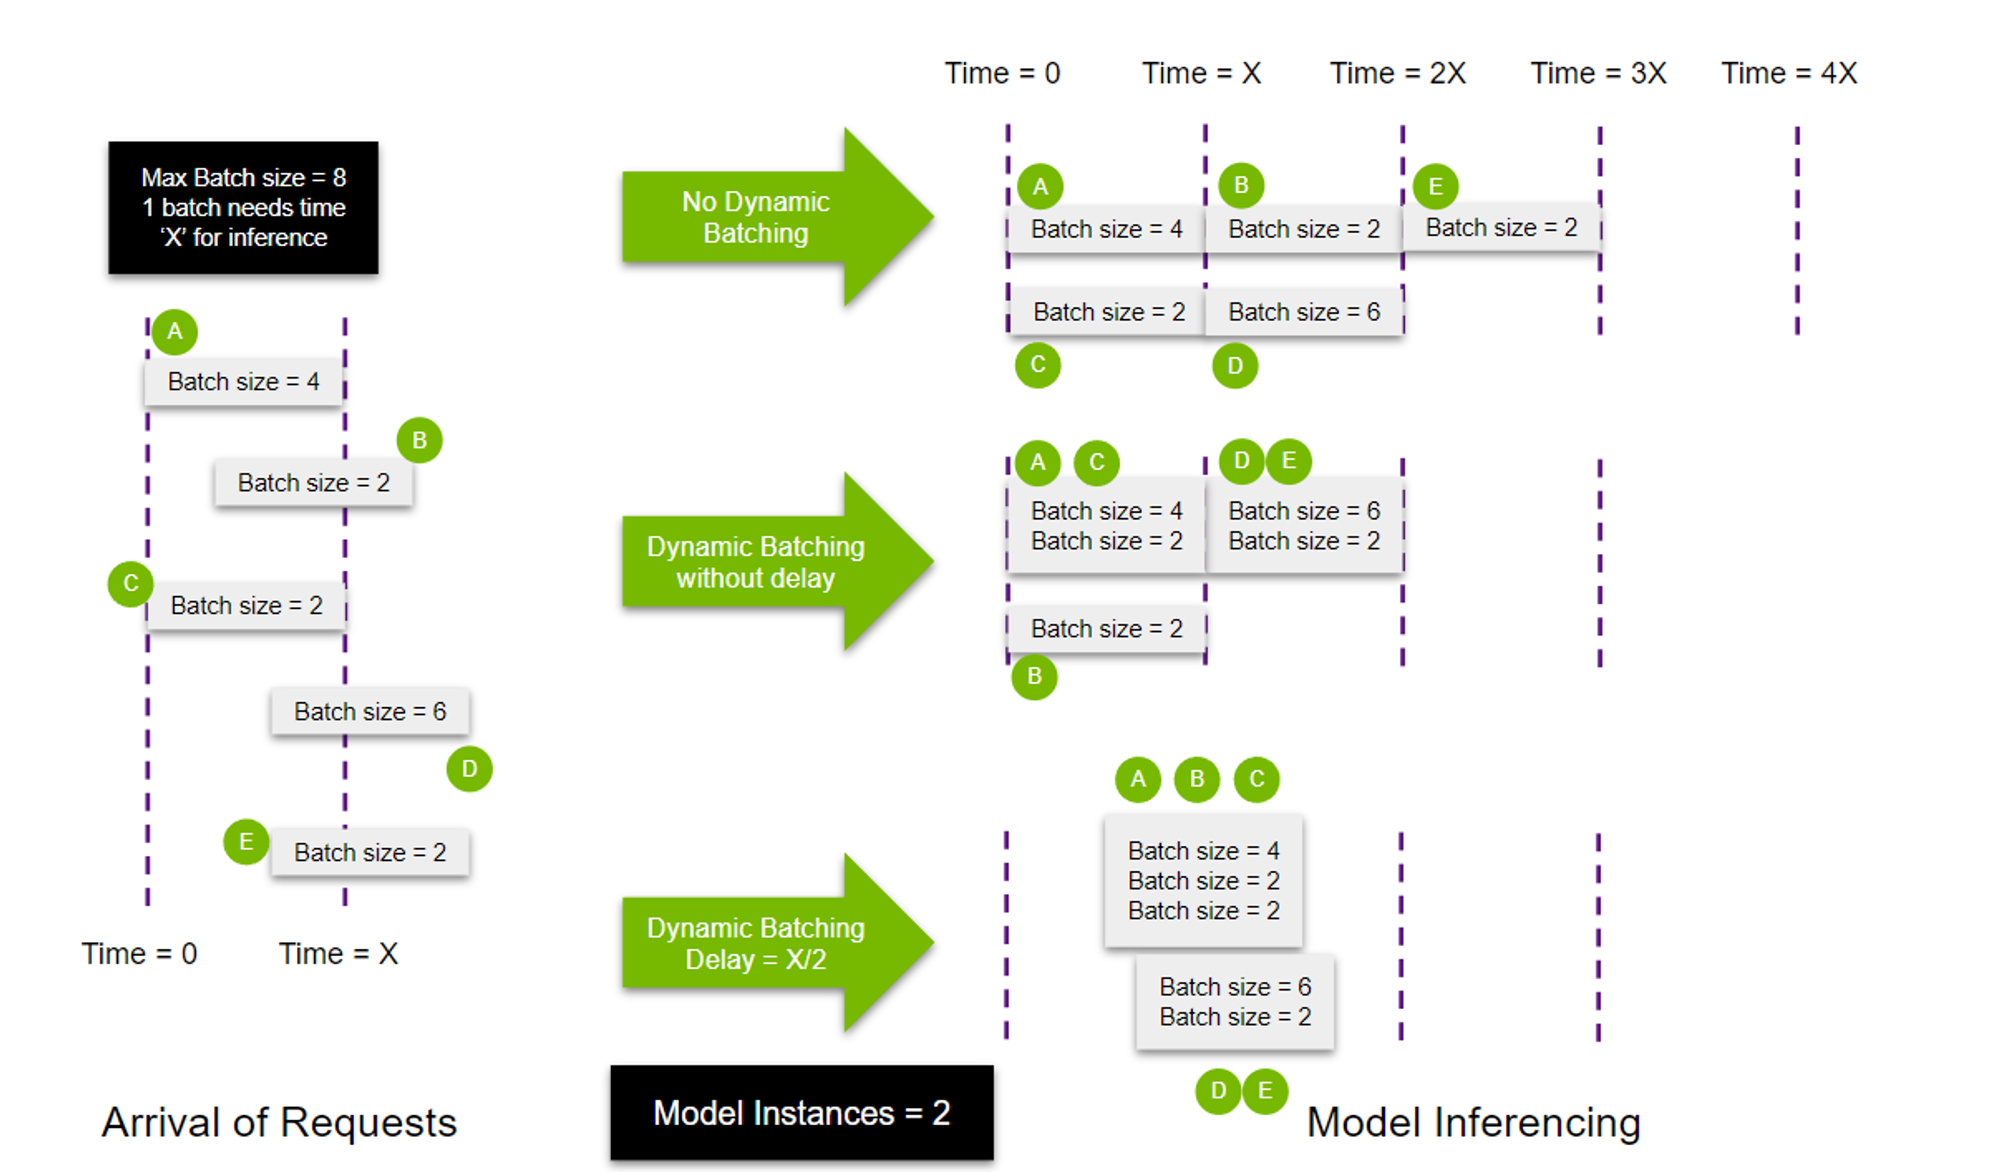
- 上図では、使用するmodel instancesは2です。そのため、1つのモデルが5つのクエリすべてを処理するのではなく、2つのモデルが作成されます。
- No Dynamic Batchingの場合、2つのモデルが実行されるため、クエリは均等に分配されます。そのうち、モデル1がリクエストAを処理し、もう一方のモデルがリクエストCを処理します。これは2つのリクエストが同時に送られたためです。AとCの処理が終わると、2つのモデルは出現順にリクエストBとDを受け取り続けます。モデル1がリクエストBを処理した後、モデル1は続けてリクエストEを受け取って処理します。
- Dynamic Batching without delayの場合、Max batch sizeは8で初期化されます。そのため、モデル1は同時に到着した2つのリクエストAとCを実行します。その後、一定の遅延で到着したリクエストBは、2番目のモデルを使って実行できます。
- Delayがある場合、モデル1は時刻T = X/2で満たされて起動し、クエリDとEが重なって最大バッチサイズ(初期値=8)を埋めるため、2番目のモデルは遅延なく実行を開始できます。
- CPU Execution: Tritonは
kind: KIND_CPUを指定してモデルをCPU上で実行できます。これはロジックモデル(Python backend)や、GPUの恩恵をあまり受けない従来型MLモデル(XGBoost、Scikit-learn)に有用です。
一般的なbackend
Triton Inference Serverは、著名なライブラリやプラットフォーム上で構築されたモデルの推論を実行するために、多くのbackendをサポートしています。以下はTISがサポートする一般的なbackendです。
- PyTorch Backend: TorchScript形式へ変換されたモデルをサポートし、config.pbtxtのplatform変数をpytorch_libtorchとして宣言することで使用します。
- ONNX Runtime Backend: ONNX形式へ変換されたモデルをサポートし、config.pbtxtのplatform変数をonnxruntime_onnxとして宣言することで使用します。
- Python Backend: 通常の標準に従わないモデル、または推論の前後にPythonでタスクを実行する必要があるモデルの推論ワークフローをサポートします。config.pbtxtのplatform変数をpythonとして宣言することで使用します。
- OpenVINO Backend: OpenVINOプラットフォームを通じてIntelハードウェア向けに最適化されたモデルをサポートします。モデル形式は通常.xmlと.binファイルを含みます。config.pbtxtのplatform変数をopenvinoとして宣言することで使用します。
- TensorRT Backend: TensorRTを通じてNVIDIA GPU向けに最適化されたモデルをサポートします。config.pbtxtのplatform変数をtensorrt_planとして宣言することで使用します。
- TensorFlow Backend: SavedModelまたはGraphDef形式のTensorFlowモデルをサポートします。使用するには、モデル形式に応じてconfig.pbtxtのplatform変数をtensorflow_savedmodelまたはtensorflow_graphdefとして宣言します。
Python backendの使用例
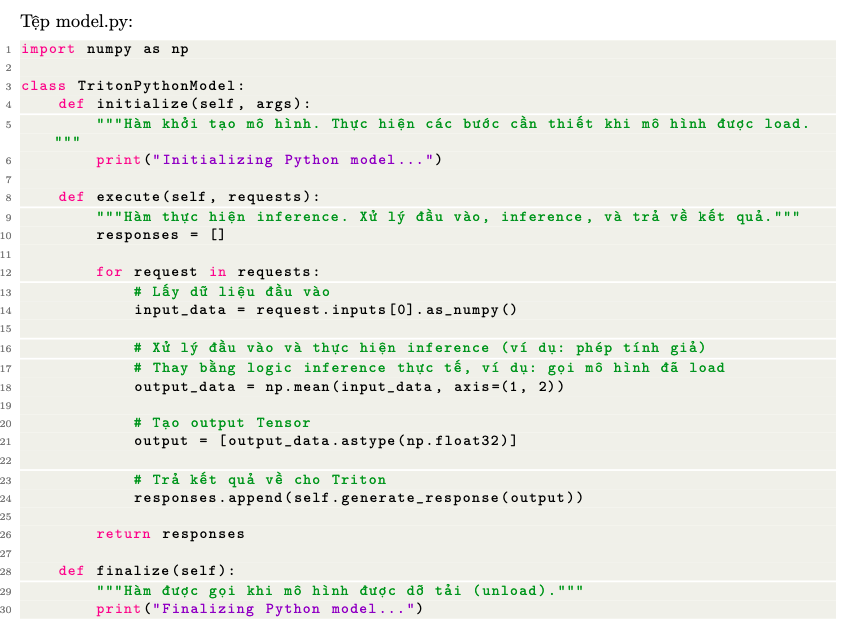
各関数の意味は次のとおりです。
- initialize: Tritonがモデルをロードしたときに初期化します。モデルや必要なリソースの読み込みに使えます。
- execute: クライアントからリクエストがあったときに推論を実行する関数です。ここでは、入力データに対する平均値計算を使ってモデル処理を模擬しています(実際の推論ではTensorFlow、PyTorch、その他任意のライブラリを呼び出せます)。
- finalize: Tritonがモデルをアンロードするときに呼ばれ、通常はリソース解放やクリーンアップを行います。
いくつかの高度な機能
以下は、推論プロセスの性能を最適化するために使えるTriton Inference Serverの高度な機能です。
Dynamic Batching
- 複数の推論リクエストを自動的に1つの大きなバッチへ結合し、同時に処理できるようにする機能です。これによりスループットが向上し、特にGPUなどのハードウェア資源の利用が最適化されます。Triton Inference Serverは短い時間だけ待ち、推論リクエストをバッチへ集めます。これによりTISは、応答時間へ大きく影響することなく、リクエストの処理レイテンシを下げられます。
- トレードオフ(Trade-off): スループットは上がりますが、個々のリクエストのレイテンシは待ち時間分だけ増加します。この手法は計算コストの高いモデル(compute-bound)で最も効果的です。
Dynamic Batchingを使うには、config.pbtxtで次のように設定します。
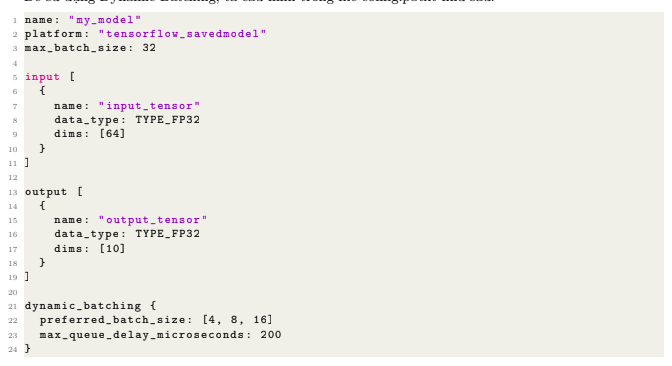
この設定では:
- max_batch_sizeは32で、モデルが処理できる最大バッチサイズを制限します
- preferred_batch_sizeは、リクエストをサイズ4、8、または16のバッチへまとめることを優先します。
- max_queue_delay_microsecondsは200 microsecondsです。つまりTritonは現在のバッチを処理する前に最大200 microseconds待ちます。
Scheduling & Queuing
Tritonはモデルの種類に応じて異なるスケジューリング戦略を使います。
- Default Scheduler: ステートレスモデル(Classification、Detection)向けです。アイドルな任意のインスタンスへリクエストを分配します。
- Ensemble Scheduler: パイプライン内のモデル間データフローを管理し、クライアントへは返しません。
- Sequence Batcher: ステートフルモデル(Chatbot、Voice Rec)向けです。同じ
sequence_idとcorrelation_idを持つリクエストが、時間順どおり同一インスタンスへルーティングされることを保証します。会話シーケンスの「start」と「end」も管理します。
Model Ensembles: 統合パイプライン
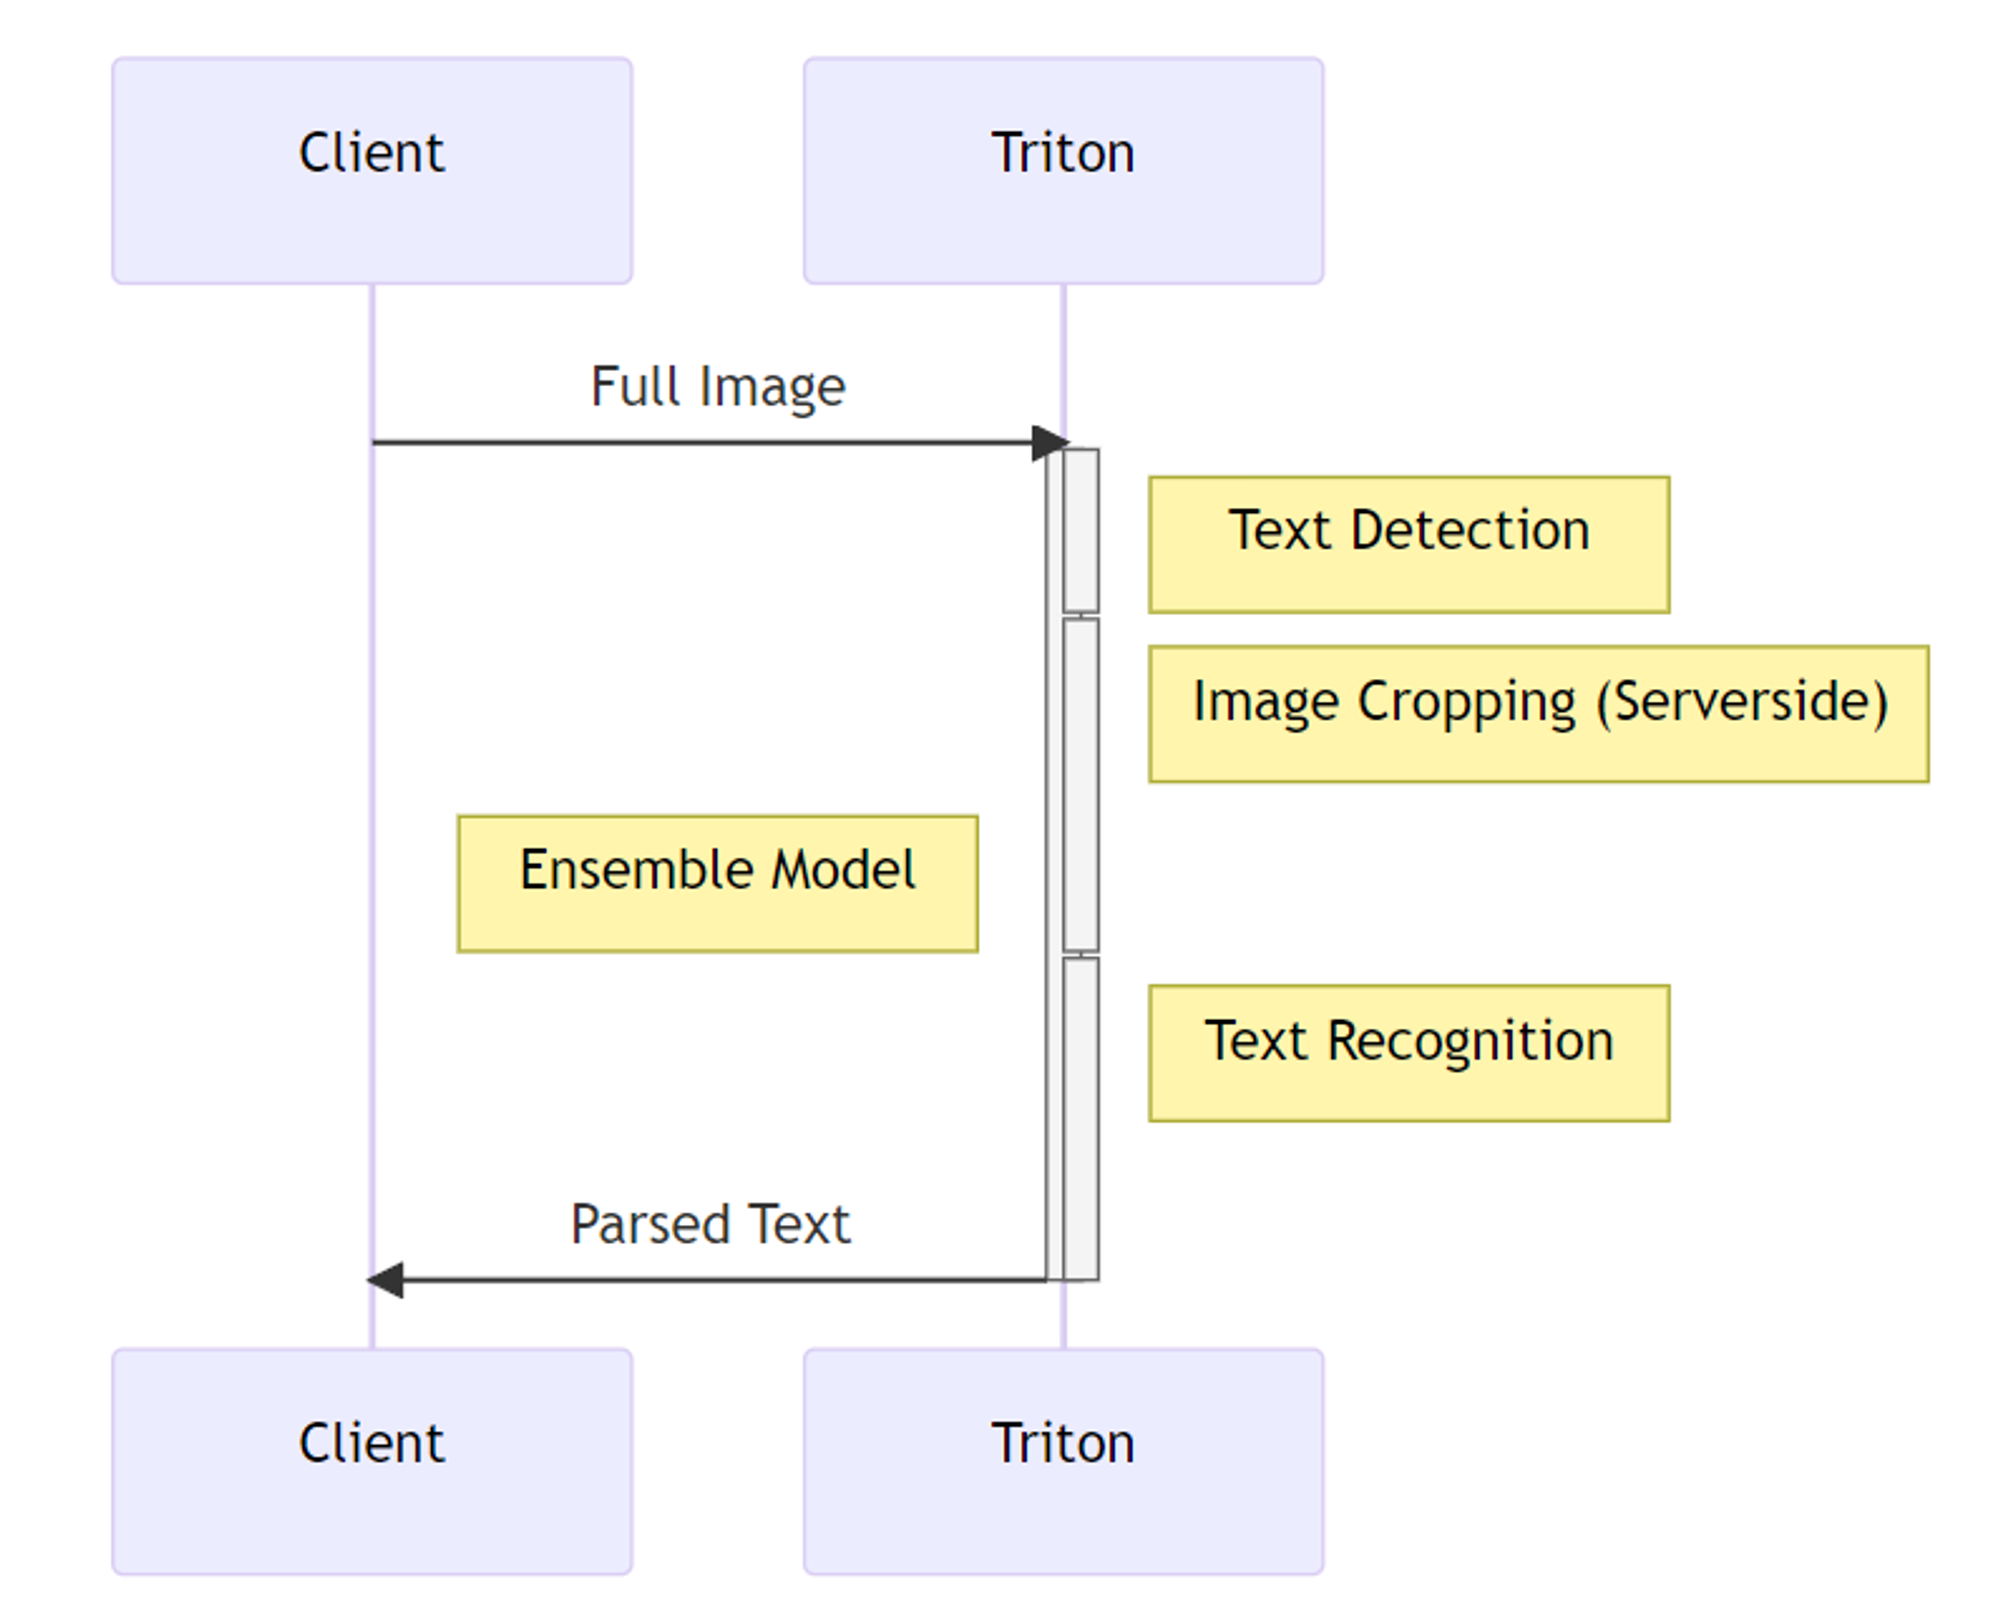
- 複数モデルから構築されたパイプラインは、モデル間でinputおよびoutput tensorsを接続し、GPUを共有して性能を最適化できます。Ensemble modelsの目的は、data preprocessing → inference → data postprocessingのように複数モデルが関与する処理をパッケージ化することです。ensemble modelsを使うと、中間テンソルの転送コストを避け、Tritonへ送る必要のあるリクエスト数を減らせます。
- Ensembleにより、Preprocessingステップ(多くの場合PythonまたはDALIで記述)とInference(TensorRT/ONNX)を1つのDAGへ結合できます。
- 利点: ネットワーク転送オーバーヘッドを排除します。例: Clientは圧縮JPEG画像(100KB)を送ります。PreprocessingをClient側で行うと、ClientはFloat32テンソル(3x224x224 約600KB)を送らなければなりません。Ensembleを使うと、ClientはJPEG(100KB)を送り → Serverが解凍・変換し → TensorRTが処理します。ネットワーク帯域を6倍節約できます。
- 構造: Ensembleモデルには実際の重みファイルはなく、データフローを定義する
config.pbtxtだけがあります(Step 1のoutput → Step 2のinput)。
Ragged Batching
ユーザーがpaddingを追加しなくても、サイズが揃っていない推論リクエストを同一バッチで処理できる機能です。これはNLPモデルや時系列モデルの推論ワークフローで特に有用です。異なる入力サイズのデータをサポートすることで、Ragged BatchingはDynamic Batchingと組み合わせて性能を最適化し、不要なメモリ使用を減らし、リクエスト処理の高い柔軟性を保ったままスループットを改善できます。
Ragged Batchingを使うには、config.pbtxtを次のように設定します。
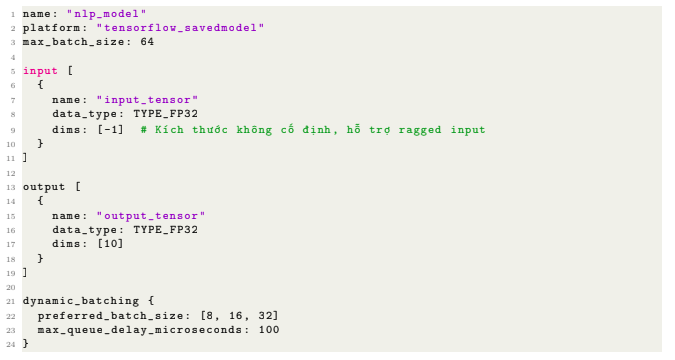
ここで:
- dims: [-1] は入力のサイズを固定しないことを許可し、異なるサイズのデータバッチをサポートします。
Model Warmup
モデルが対応するbackendとともにTIS上へロードされ初期化されるとき、一部のbackendは実際のリクエストを受け取るまで初期化の完了を遅らせることがあります。これにより、最初のリクエストの処理時間が非常に遅くなることがあります。Model Warmupはこの問題を、対応するモデルへあらかじめいくつかのリクエストを自動送信し、初期化プロセス全体を起動することで解決します。
Model Warmupを使うには、config.pbtxtを次のように設定します。
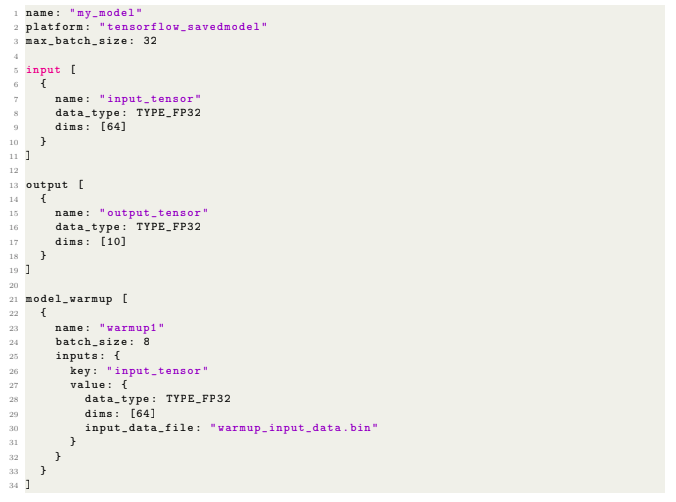
ここで:
- model_warmup: warmupプロセス向けの設定ブロックです。ここではwarmup1という名前のwarmupステップが1つあります。
- batch_size: warmupリクエストのバッチサイズは8です。
- input_data_file: warmupリクエストの入力データはファイルwarmup_input_data.bin経由で提供されます。
Response Cache
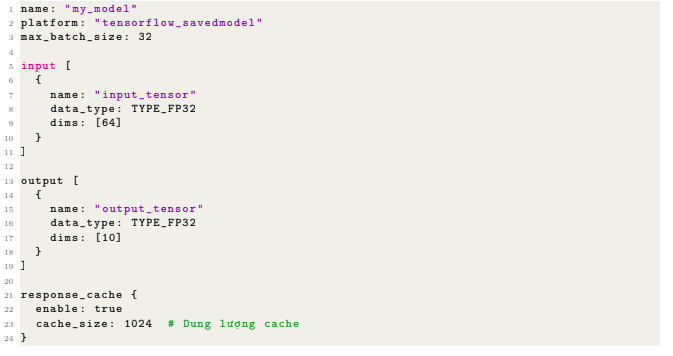
従来ソフトウェアにおけるCache機能と同様に、Response Cacheは以前に処理済みの推論リクエスト結果を保存して再利用でき、レイテンシを下げ、推論システムの性能を高めます。リクエスト結果を保存することで、システムはモデル上で推論プロセス全体を再実行せずに、キャッシュから結果を返せます。これは繰り返しリクエストが多いシステムで特に有用です。
Response Cacheを使うには、config.pbtxtを次のように設定します
Best PracticesとProduction向け最適化
モデルを動かせることは最初の一歩です。高負荷に耐え、安定して動くよう最適化することが、MLOpsプロジェクトの成否を決めるステップです。
Triton Performance Analyzer(perf_analyzer)
- Triton Server上で稼働中のモデルをベンチマークするために使います:
- latency(p50、p90、p95、p99)
- throughput(infer/sec)
- GPU utilization
- request concurrency
- server queue time
- batch size performance
YAMLファイルを作成
version: 1
model_repository: /models
output_model_repository_path: /results

profile_models:
  arcface_tensorrt:
    parameters:
      batch_sizes: [1, 4, 8, 16]
      concurrency: [1, 2, 4, 8]
analyzerを実行
model-analyzer analyze -f config.yaml
2種類のレポートが生成されます
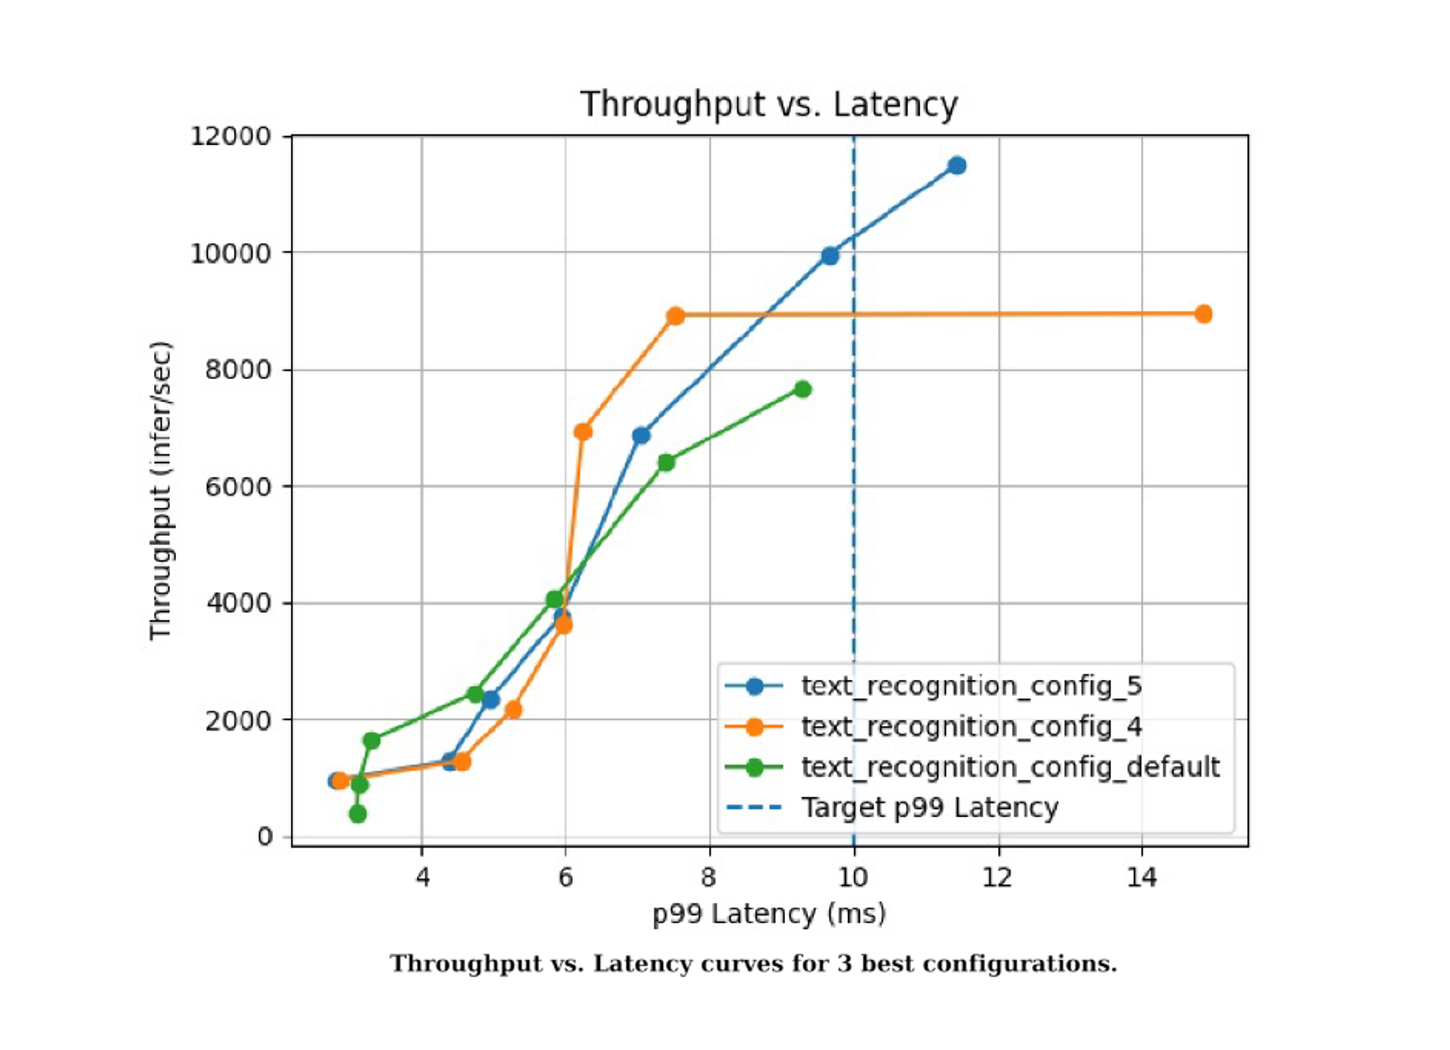
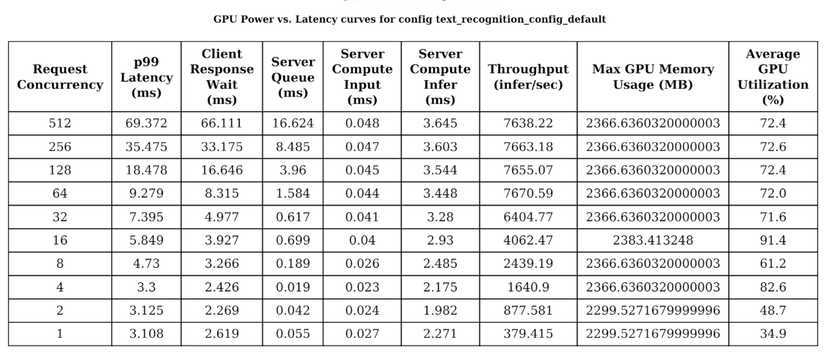
Model AnalyzerによるPerformance Tuning
設定パラメータ(max_batch_size、instance_count)を勘で決めるべきではありません。NVIDIAは最適点(Sweet Spot)を自動探索するModel Analyzerを提供しています。
Model Analyzerは「知的な総当たり(intelligent brute-force)」プロセスを実行します。
- 設定を自動変更します(例: バッチサイズを1から128まで試し、インスタンス数を1から4まで試す)。
- 負荷を模擬したベンチマークを実行します(内部でPerf Analyzerを使用)。
- LatencyとThroughputを計測します。
- 目標(例: Latency < 10ms)に基づいて最良の
config.pbtxtを提案します。
実行コマンドの例:
model-analyzer profile -m resnet50 --profile-models resnet50 --output-model-repository-path output_repo
Framework Optimization(TensorRT & ONNX Runtime)
- TensorRTへの変換: NVIDIA GPU上で最も効果的な最適化手法です。TensorRTは「Kernel Fusion」(ネットワーク層を結合してメモリアクセスを削減)を実行し、低精度計算(FP16/INT8)をサポートします。PyTorchからTensorRT(
.plan)への変換は、多くの場合2倍から6倍の速度向上をもたらします。 - ONNX Runtime: モデルにTensorRTがまだサポートしていない複雑な演算子(Operators)がある場合、ONNX RuntimeはネイティブPyTorchより高い性能と幅広い互換性を持つ良い代替です。
Metrics & Monitoring(Prometheus & Grafana)
Productionでは可観測性(Observability)が必須です。Tritonはポート8002にmetricsエンドポイントを組み込み済みです。
Prometheus設定(prometheus.yml):
scrape_configs:
  - job_name: 'triton'
    static_configs:
      - targets: ['triton-server:8002']
Grafanaで監視すべき重要な指標:
nv_inference_request_success: 成功したリクエスト数(Throughput)。nv_inference_queue_duration_us: リクエストがキューで待っている時間(Dynamic Batchingが活発に動作しているか、遅延を引き起こしているかを示します)。nv_inference_compute_infer_duration_us: GPUが実際に計算している時間。nv_gpu_utilization: GPU使用率。
メモリ管理(OOMエラーの回避)
1つのGPU上で多数のモデルをホストする場合、OOMは大きなリスクです。解決策には次が含まれます。
- Rate Limiting: Tritonの
Rate Limiter機能を使い、実行へ投入される同時リクエスト数を制限します。 - Explicit Model Loading:
-model-control-mode=explicitを設定します。起動時にすべてのモデルをロードする(すぐにOOMを起こしやすい)代わりに、Tritonは管理APIが呼ばれたときだけモデルをロードします。これにより動的なLoad/Unload戦略が可能になります。-
Model Control Modes:
TritonはHTTP/RESTおよびgRPCプロトコルの一部として、またC APIの一部としてモデル管理APIを提供します。TritonはNONE、EXPLICIT、POLLの3つのmodel control modesのいずれかで動作します。Model control modeは、Tritonがモデルリポジトリへの変更をどう扱うか、どのプロトコルまたはAPIが利用可能かを決めます。
- NONE: Tritonは起動時にモデルリポジトリ内のすべてのモデルをロードしようとします。ロードできないモデルはUNAVAILABLEとされ、推論時に利用できません。サーバー実行中のmodel repositoryへの変更は無視されます。model controlプロトコルを使ったmodel loadおよびunloadリクエストは効果がなく、エラー応答を返します。Triton起動時には
-model-control-mode=none(default)を指定します。 - EXPLICIT: 起動時、Tritonはコマンドライン
-load-modelで明示的に指定されたモデルだけをロードします。起動後は、すべてのmodel loadまたはunloadを、モデル制御プロトコル(model control protocol)を使って明示的に開始する必要があります。model-control-mode=explicitを指定します。 - POLL: Tritonは起動時にモデルリポジトリ内のすべてのモデルをロードしようとします。model repositoryへの変更は検出され、Tritonはその変更に基づいて必要に応じてloadおよびunloadを試みます。model control protocolを使ったmodel loadおよびunloadリクエストは効果がなく、エラー応答を返します。
model-control-mode=pollを指定する必要があります。
- NONE: Tritonは起動時にモデルリポジトリ内のすべてのモデルをロードしようとします。ロードできないモデルはUNAVAILABLEとされ、推論時に利用できません。サーバー実行中のmodel repositoryへの変更は無視されます。model controlプロトコルを使ったmodel loadおよびunloadリクエストは効果がなく、エラー応答を返します。Triton起動時には
-
- Unified Memory(TensorRT): TensorRTエンジンをビルドするとき、VRAMが満杯になった場合にシステムメモリ(System RAM)をバッファとして使うことを許可でき、クラッシュを避けるために性能低下を受け入れます。
ケーススタディ: 顔認識システム(Face Recognition Pipeline)
Dockerによる環境セットアップ
まず、DockerとNVIDIA Container Toolkitをインストールします。その後、Triton Serverイメージをpullします。
# Triton Serverイメージをpull(PyTorch、TensorFlow、ONNXなどのbackendを含む)
# NVIDIAドライバに合うバージョンxx.yyを選択(例: 23.10)
docker pull nvcr.io/nvidia/tritonserver:23.10-py3

# SDKイメージをpull(クライアントライブラリとサンプルツールを含む)
docker pull nvcr.io/nvidia/tritonserver:23.10-py3-sdk
この節では、これまでの知識を複雑なシナリオに適用します。リアルタイム顔認識パイプラインです。
システム要件:
- Face Detection: RetinaFaceモデル(Input: 元画像 → Output: N個のBounding Boxes)。
- 処理ロジック: Bounding Boxesに基づいて顔を切り出し(Crop)し、位置合わせ(Align)します。顔の数Nは動的です(0、1、または複数の顔)。
- Feature Extraction: ArcFaceモデル(Input: N枚の112x112顔画像バッチ → Output: N個の512次元特徴ベクトル)。
課題: Tritonの従来のEnsembleモデル(DAG)は線形で静的です。画像ごとに変化する動的な顔の数Nを扱うためのループ(Loops)や条件分岐(Conditionals)をサポートしません。
解決策: Python Backendを通じた**Business Logic Scripting(BLS)**をオーケストレータ(Orchestrator)として使います。Python Backendがリクエストを受け取り、RetinaFaceを呼び出し、NumPy/OpenCVで画像切り出しロジックを処理し、その後ArcFaceを呼び出します。
データフロー設計(Pipeline Architecture)
システムはmodel_repository内の4つのモデルで構成されます。
| 段階 | 責務 |
|---|---|
| RetinaFace | bounding boxes + landmarksの検出 |
| Python Backend | Orchestrator: resize → call inference → crop → align → batching |
| ArcFace | 各顔に対する512-d embeddingの計算 |
| Client | 画像を送信 → embeddingsのリストを受信 |
実行フロー:
Clientが画像を送信 → face_pipeline(Python) → pb_utils.InferenceRequest → retinaface_tensorrt → Boxesを返す → Pythonコードが画像をcrop → pb_utils.InferenceRequest → arcface_tensorrt(Batch N) → Embeddingsを返す → Client。
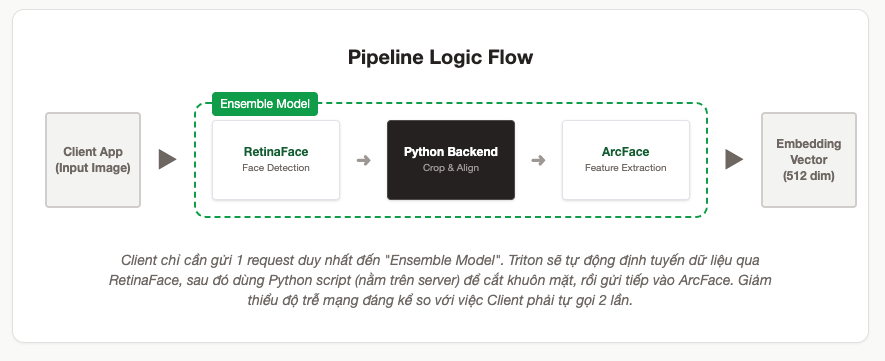
model_repositoryのディレクトリ構造
model_repository/
│
├── retinaface_tensorrt/
│   ├── 1/
│   │   └── model.plan
│   └── config.pbtxt
│
├── arcface_tensorrt/
│   ├── 1/
│   │   └── model.plan
│   └── config.pbtxt
│
└── face_pipeline/
    ├── 1/
    │   └── model.py
    └── config.pbtxt
retinaface_tensorrtの設定
config.pbtxtファイル
name: "retinaface_tensorrt"
backend: "tensorrt"
max_batch_size: 1

input [
  {
    name: "input"
    data_type: TYPE_FP32
    dims: [3, 640, 640]
  }
]

output [
  {
    name: "bboxes"
    data_type: TYPE_FP32
    dims: [-1, 4]      # N x 4
  },
  {
    name: "landmarks"
    data_type: TYPE_FP32
    dims: [-1, 10]     # N x 5 landmarks
  },
  {
    name: "scores"
    data_type: TYPE_FP32
    dims: [-1]
  }
]
arcface_tensorrtの設定
config.pbtxtファイル
name: "arcface_tensorrt"
backend: "tensorrt"

max_batch_size: 64

input [
  {
    name: "input"
    data_type: TYPE_FP32
    dims: [3, 112, 112]
  }
]

output [
  {
    name: "embedding"
    data_type: TYPE_FP32
    dims: [512]
  }
]
face_pipelineの設定(Python Backend + Orchestrator)
config.pbtxtファイル
name: "face_pipeline"
backend: "python"
max_batch_size: 1

input [
  {
    name: "input_image"
    data_type: TYPE_UINT8
    dims: [-1]   # raw bytes
  }
]

output [
  {
    name: "face_count"
    data_type: TYPE_INT32
    dims: [1]
  },
  {
    name: "embeddings"
    data_type: TYPE_FP32
    dims: [-1, 512]  # N x 512
  }
]
model.pyファイル
import numpy as np
import triton_python_backend_utils as pb_utils
import cv2
import io

class TritonPythonModel:

    def initialize(self, args):
        self.model_name = args["model_name"]

    def execute(self, requests):
        responses = []

        for request in requests:
            # -------------------------
            # 1. クライアントから画像を取得
            # -------------------------
            image_bytes = pb_utils.get_input_tensor_by_name(
                request, "input_image"
            ).as_numpy().tobytes()

            img_array = np.frombuffer(image_bytes, dtype=np.uint8)
            img = cv2.imdecode(img_array, cv2.IMREAD_COLOR)
            h, w = img.shape[:2]

            # RetinaFace向けに入力をリサイズ(モデルによる)
            img_resized = cv2.resize(img, (640, 640))
            img_input = img_resized.transpose(2, 0, 1).astype(np.float32)

            # -------------------------
            # 2. RetinaFaceモデルを呼び出す
            # -------------------------
            retina_req = pb_utils.InferenceRequest(
                model_name="retinaface_tensorrt",
                requested_output_names=["bboxes", "landmarks", "scores"],
                inputs=[
                    pb_utils.Tensor.from_numpy("input", img_input[np.newaxis, ...])
                ]
            )

            retina_res = retina_req.exec()

            bboxes = pb_utils.get_output_tensor_by_name(
                retina_res, "bboxes"
            ).as_numpy()

            landmarks = pb_utils.get_output_tensor_by_name(
                retina_res, "landmarks"
            ).as_numpy()

            scores = pb_utils.get_output_tensor_by_name(
                retina_res, "scores"
            ).as_numpy()

            # -------------------------
            # 3. thresholdで顔をフィルタ
            # -------------------------
            valid_idx = np.where(scores > 0.8)[0]
            bboxes = bboxes[valid_idx]
            landmarks = landmarks[valid_idx]

            faces_cropped = []

            for box, lmk in zip(bboxes, landmarks):
                x1, y1, x2, y2 = box.astype(int)
                face = img[y1:y2, x1:x2]

                # 顔の位置合わせ(任意): skipするかsimilarity transformを使う
                face = cv2.resize(face, (112, 112))
                face = face[:, :, ::-1]  # BGR → RGB
                face = face.transpose(2, 0, 1).astype(np.float32)
                faces_cropped.append(face)

            if len(faces_cropped) == 0:
                # 顔なしを返す
                empty_emb = np.zeros((0, 512), dtype=np.float32)
                responses.append(
                    pb_utils.InferenceResponse(
                        output_tensors=[
                            pb_utils.Tensor.from_numpy("face_count", np.array([0], dtype=np.int32)),
                            pb_utils.Tensor.from_numpy("embeddings", empty_emb)
                        ]
                    )
                )
                continue

            faces_batch = np.stack(faces_cropped, axis=0)

            # -------------------------
            # 4. ArcFaceをバッチNで呼び出す
            # -------------------------
            arc_req = pb_utils.InferenceRequest(
                model_name="arcface_tensorrt",
                requested_output_names=["embedding"],
                inputs=[
                    pb_utils.Tensor.from_numpy("input", faces_batch)
                ]
            )

            arc_res = arc_req.exec()

            embeddings = pb_utils.get_output_tensor_by_name(
                arc_res, "embedding"
            ).as_numpy()

            # -------------------------
            # 5. クライアントへ結果を返す
            # -------------------------
            responses.append(
                pb_utils.InferenceResponse(
                    output_tensors=[
                        pb_utils.Tensor.from_numpy("face_count", np.array([embeddings.shape[0]], dtype=np.int32)),
                        pb_utils.Tensor.from_numpy("embeddings", embeddings.astype(np.float32)),
                    ]
                )
            )

        return responses
サーバーの起動
# コンテナを実行し、モデルディレクトリをコンテナ内の /models にマウント
docker run --gpus all --rm \
  -p 8000:8000 -p 8001:8001 -p 8002:8002 \
  -v $(pwd)/triton_repo:/model_repository \
  --shm-size=1g --ulimit memlock=-1 --ulimit stack=67108864 \
  nvcr.io/nvidia/tritonserver:23.10-py3 \
  tritonserver --model-repository=/model_repository
クライアントからのリクエスト送信
import cv2
import numpy as np
import tritonclient.http as httpclient

triton = httpclient.InferenceServerClient("localhost:8000")

img = cv2.imread("test.jpg")
_, buf = cv2.imencode(".jpg", img)

input_image = np.frombuffer(buf.tobytes(), dtype=np.uint8)

inputs = [httpclient.InferInput("input_image", input_image.shape, "UINT8")]
inputs[0].set_data_from_numpy(input_image)

outputs = [
    httpclient.InferRequestedOutput("face_count"),
    httpclient.InferRequestedOutput("embeddings")
]

res = triton.infer("face_pipeline", inputs, outputs=outputs)

print("Face count =", res.as_numpy("face_count"))
print("Embeddings shape =", res.as_numpy("embeddings").shape)
参考文献
- TRITON INFERENCE SERVER - AIVN Build Beta AIO 2024
- Model Server: A Key Component of MLOps - ConsciousML、2025年12月2日閲覧、https://www.axelmendoza.com/posts/model-server/
- Best Model Serving Runtimes To Build Optimized ML APIs - ConsciousML、2025年12月2日閲覧、https://www.axelmendoza.com/posts/best-model-serving-runtimes/
- Best Tools For ML Model Serving - Neptune.ai、2025年12月2日閲覧、https://neptune.ai/blog/ml-model-serving-best-tools
- Scaling Deep Learning Models in Production for millions of users | by Lucas de Lima Nogueira | Medium、2025年12月2日閲覧、https://medium.com/@lucasdelimanogueira/scaling-deep-learning-models-in-production-for-millions-of-users-779baff25dde
- Why use ML server frameworks like Triton Inf server n torchserve for cloud prod? What would u recommend? : r/mlops - Reddit、2025年12月2日閲覧、https://www.reddit.com/r/mlops/comments/1frcu8b/why_use_ml_server_frameworks_like_triton_inf/
- The Triton Inference Server provides an optimized cloud and edge inferencing solution. - GitHub、2025年12月2日閲覧、https://github.com/triton-inference-server/server
- Model Configuration — NVIDIA Triton Inference Server 1.12.0 documentation、2025年12月2日閲覧、https://docs.nvidia.com/deeplearning/triton-inference-server/archives/triton_inference_server_1120/triton-inference-server-guide/docs/model_configuration.html
- Inference Protocols and APIs — NVIDIA Triton Inference Server - NVIDIA Docs Hub、2025年12月2日閲覧、https://docs.nvidia.com/deeplearning/triton-inference-server/archives/triton-inference-server-2390/user-guide/docs/customization_guide/inference_protocols.html
- HTTP/REST and GRPC Protocol — NVIDIA Triton Inference Server、2025年12月2日閲覧、https://docs.nvidia.com/deeplearning/triton-inference-server/user-guide/docs/protocol/README.html
- server/docs/getting_started/quickstart.md at main · triton-inference-server/server - GitHub、2025年12月2日閲覧、https://github.com/triton-inference-server/server/blob/main/docs/getting_started/quickstart.md
- Deploy models using Triton — NVIDIA Triton Inference Server - NVIDIA Docs Hub、2025年12月2日閲覧、https://docs.nvidia.com/deeplearning/triton-inference-server/user-guide/docs/tutorials/Conceptual_Guide/Part_1-model_deployment/README.html
- Model Instance Kind Example — NVIDIA Triton Inference Server、2025年12月2日閲覧、https://docs.nvidia.com/deeplearning/triton-inference-server/user-guide/docs/python_backend/examples/instance_kind/README.html
- Serving ML Model Pipelines on NVIDIA Triton Inference Server with Ensemble Models、2025年12月2日閲覧、https://developer.nvidia.com/blog/serving-ml-model-pipelines-on-nvidia-triton-inference-server-with-ensemble-models/
- Model Configuration — NVIDIA Triton Inference Server 2.0.0 documentation、2025年12月2日閲覧、https://docs.nvidia.com/deeplearning/triton-inference-server/archives/triton_inference_server_1140/user-guide/docs/model_configuration.html
- Dynamic Batching & Concurrent Model Execution — NVIDIA Triton Inference Server、2025年12月2日閲覧、https://docs.nvidia.com/deeplearning/triton-inference-server/user-guide/docs/tutorials/Conceptual_Guide/Part_2-improving_resource_utilization/README.html
- Ensemble Models — NVIDIA Triton Inference Server、2025年12月2日閲覧、https://docs.nvidia.com/deeplearning/triton-inference-server/user-guide/docs/user_guide/ensemble_models.html
- Trition with post and pre processing - Njord tech blog、2025年12月2日閲覧、https://www.njordy.com/2023/02/01/Trition_with_post_and_pre_processing/
- Serving a Torch-TensorRT model with Triton - PyTorch documentation、2025年12月2日閲覧、https://docs.pytorch.org/TensorRT/tutorials/serving_torch_tensorrt_with_triton.html
- NVIDIA Triton Inference Server Boosts Deep Learning Inference | NVIDIA Technical Blog、2025年12月2日閲覧、https://developer.nvidia.com/blog/nvidia-serves-deep-learning-inference/
- Triton Client Libraries and Examples — NVIDIA Triton Inference Server - NVIDIA Docs Hub、2025年12月2日閲覧、https://docs.nvidia.com/deeplearning/triton-inference-server/user-guide/docs/client/README.html
- Model Clients - PyTriton、2025年12月2日閲覧、https://triton-inference-server.github.io/pytriton/latest/clients/
- From Research to Production I: Efficient Model Deployment with Triton Inference Server、2025年12月2日閲覧、https://makeitnew.io/from-research-to-production-i-efficient-model-deployment-with-triton-inference-server-79347f1b4b08
- Identifying the Best AI Model Serving Configurations at Scale with NVIDIA Triton Model Analyzer | NVIDIA Technical Blog、2025年12月2日閲覧、https://developer.nvidia.com/blog/identifying-the-best-ai-model-serving-configurations-at-scale-with-nvidia-triton-model-analyzer/
- Model Analyzer CLI — NVIDIA Triton Inference Server、2025年12月2日閲覧、https://docs.nvidia.com/deeplearning/triton-inference-server/user-guide/docs/model_analyzer/docs/cli.html
- Metrics — NVIDIA Triton Inference Server、2025年12月2日閲覧、https://docs.nvidia.com/deeplearning/triton-inference-server/user-guide/docs/user_guide/metrics.html
- Observability — NVIDIA NIM for Multimodal Safety、2025年12月2日閲覧、https://docs.nvidia.com/nim/multimodal-safety/latest/observability.html
- Prometheus output differs from nvidia-smi · Issue #2122 · triton-inference-server/server、2025年12月2日閲覧、https://github.com/triton-inference-server/server/issues/2122
- Business Logic Scripting — NVIDIA Triton Inference Server、2025年12月2日閲覧、https://docs.nvidia.com/deeplearning/triton-inference-server/user-guide/docs/user_guide/bls.html
- Python Backend — NVIDIA Triton Inference Server、2025年12月2日閲覧、https://docs.nvidia.com/deeplearning/triton-inference-server/user-guide/docs/python_backend/README.html
執筆 Huỳnh Phước Nguyên
AIエンジニア、BK Hightech