はじめに
大規模言語モデル(LLM)やAIサービス向けAPIが急速に発展する時代において、それらを利用したアプリケーションの構築はますます一般的になっています。しかし、アプリケーションが多数のユーザーにサービスを提供しなければならない場合、多数のリクエストを同時に処理することは大きな課題となります。APIには通常、リソース制限と応答時間の制約があるため、開発者は負荷分散だけでなく、ソースコードを効率よく構成することも求められます。
大量のリクエストを管理するプロジェクトに取り組むなかで、この問題に対処する一般的なアプローチが2つあることに気づきました。マルチスレッド(multithreading)と非同期プログラミング(asynchronous programming)です。それぞれの方法には長所と短所があり、選択はプロジェクトの要件だけでなく、処理ロジックの構成方法にも左右されます。
本稿の目的は、PythonにおけるConcurrency(並行性)とParallelism(並列性)の概念を明確にし、これら2つの手法をより深く理解したうえで、自身のプロジェクトへ適切に適用できるようにすることです。
前提知識: 記事が長くなりすぎないよう、基礎知識の再説明は行いません。Pythonにおける**multithreading(マルチスレッド)とasynchronous(非同期)**についての基礎理解が必要です。非同期については、後のセクションでより詳しく説明します。
概念
Concurrency(並行性)
- 並行性とは、同じ時間帯のなかで複数のタスクを管理することを指し、それらのタスクが必ずしも同じ瞬間に並列実行される必要はありません。タスクは交代しながら実行され、あたかも同時に動いているかのような印象(マルチタスク)を生み出します。
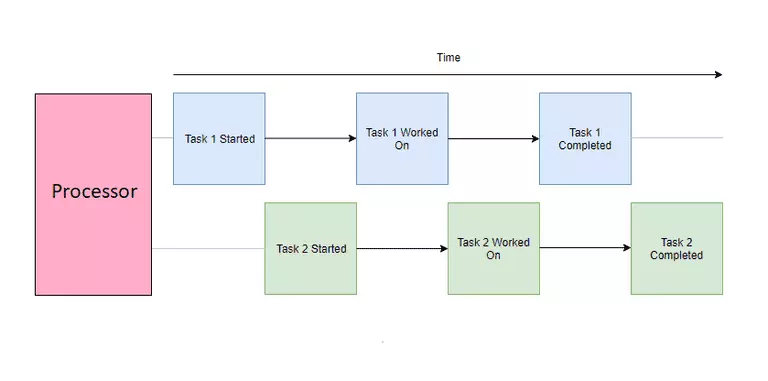
- 並行性は通常、multithreading(GIL — Global Interpreter Lock のため。これはある時点で1つのスレッドだけが実行できるように制限する仕組みであり、その結果 Python のマルチスレッドはスレッドを並行に実行するにとどまります)とasynchronousプログラミングによって実装されます。プログラムはタスク間を切り替えながら複数の作業を処理でき、必ずしもすべてを同時に実行しなくても、各タスクを進めることができます。
Parallelism(並列性)
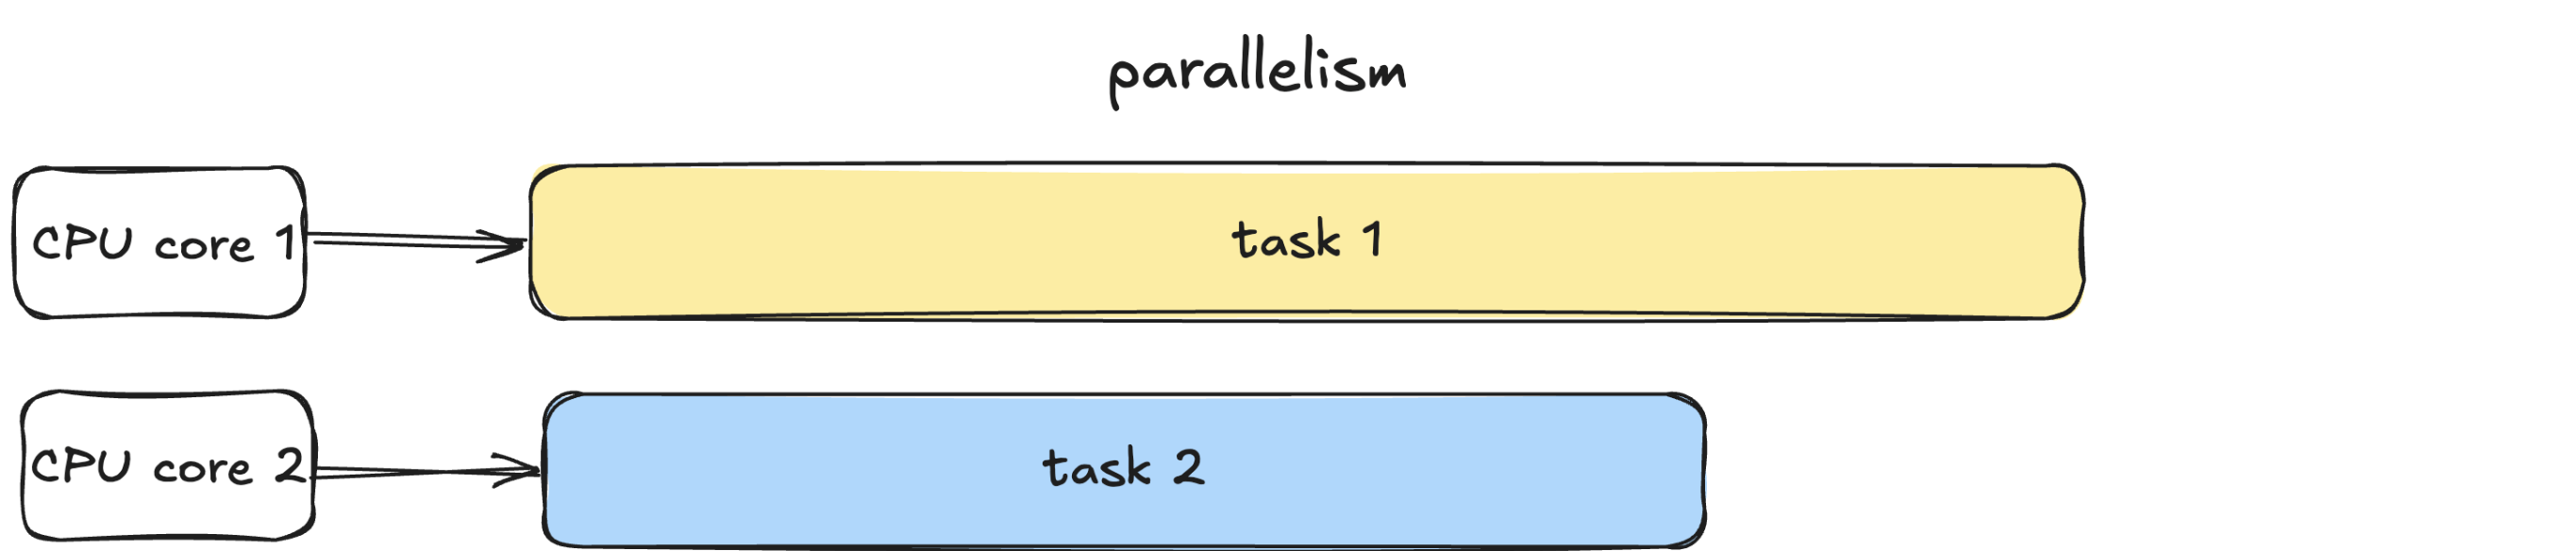
- 並列処理、あるいは並列計算とは、複数のタスクを同時に実行できる能力であり、あるタスクの実行が別のタスクを中断しないことです。
- 並列性は通常、multiprocessing によって達成され、複数のプロセスを異なるCPUコア上で実行します。
比較
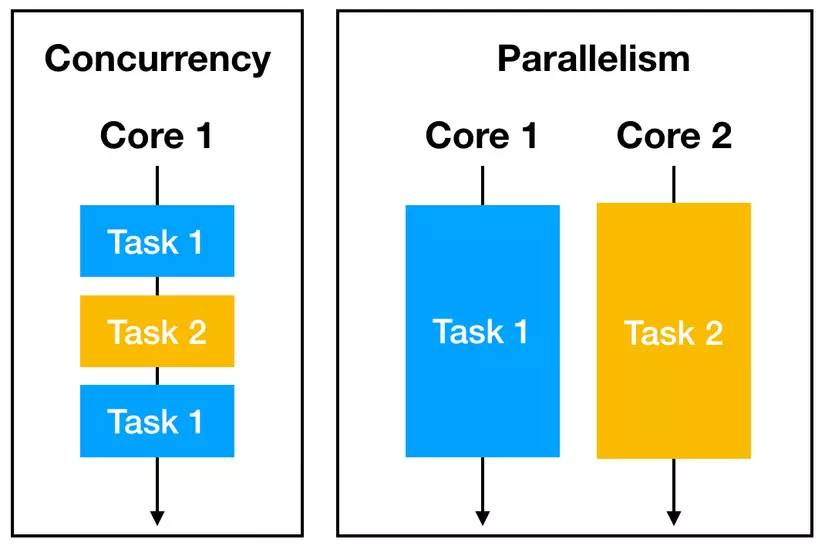
では、これら2つの概念の違いは何でしょうか。concurrencyでは、タスクの開始と終了が重なっていればよく、タスクの作業がその瞬間に同時実行される必要はありません。一方、parallelismでは同時実行されます。言い換えれば、concurrencyはparallelismの部分集合です。Concurrencyはプロセッサの単一CPUコア上でも実行でき、その場合CPUは所定の仕組みに従って、あるときはこのタスク、あるときはあのタスクと時間を分割します。Parallelismに対しては、複数のCPUコアを持つプロセッサが必要であり、各タスクは独立したCPU上で実行されます。
プログラム
プログラムは、Pythonスクリプトや実行ファイルのような静的なファイルにすぎません。
- プログラムはディスク上に受動的な状態で存在し、オペレーティングシステム(OS)がメモリへロードして実行するまで動作しません。それが起こると、プログラムはプロセス(process)になります。
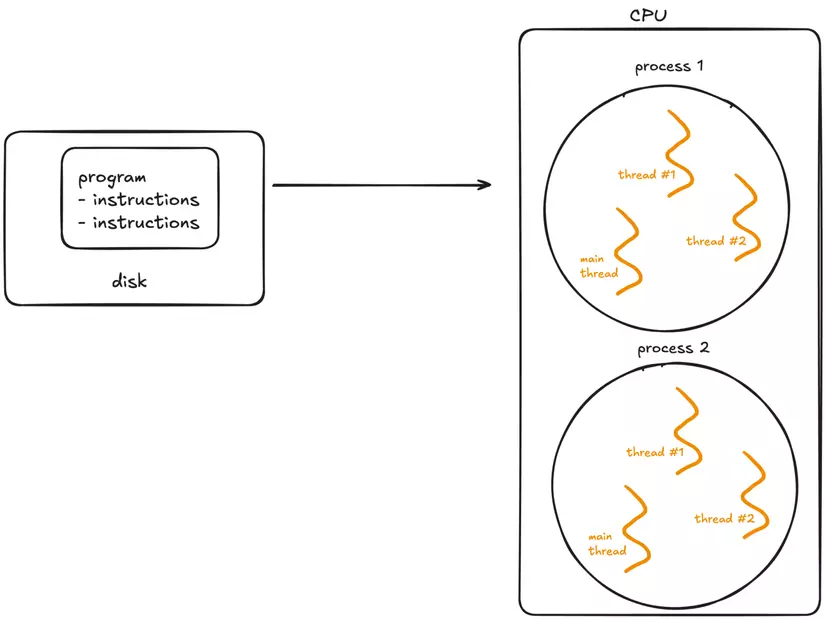
1つのプロセスのなかでは、複数のスレッドを生成して異なる作業を並列に実行でき、オペレーティングシステムのマルチタスク能力を活用できます。
プロセス(Process)
プロセスは、実行中のプログラムの独立した実体です。
- 各プロセスは独自のメモリ空間、独自のリソース、独自の実行状態を持ちます。プロセス同士は隔離されており、あるプロセスが別のプロセスに干渉できないことを意味します。ただし、それを可能にするために特別に設計されたプロセス間通信(IPC)などの仕組みを通す場合は例外です。
- プロセスは通常、次の2つの主要な種類に分類されます。
- I/O-boundプロセス: ファイルアクセス、ネットワーク通信、ユーザー入力待ちなど、入出力操作の完了を待つことに時間の大部分を費やします。待機中、CPUはほとんどアイドル状態です。
- CPU-boundプロセス: 計算の実行に時間の大部分を費やします(例: 動画エンコード、数値解析)。これらのタスクは非常に多くのCPU時間を必要とします。
- プロセスのライフサイクル:
- プロセスは生成されると new 状態から始まります。
- その後 ready 状態へ移り、CPU時間の割り当てを待ちます。
- プロセスが何らかのイベント(例: I/O)を待たなければならない場合、waiting 状態へ移ります。
- 最後に、作業を完了すると終了します。
スレッド(Thread)
スレッドは、プロセス内部における最小の実行単位です。プロセスはスレッドを収める「コンテナ」として機能し、そのプロセスのライフサイクルを通じて多数のスレッドを生成・破棄できます。
- すべてのプロセスには少なくとも1つのスレッド — メインスレッドと呼ばれます — がありますが、追加のワーカースレッドを生成することもできます。
- スレッドは同一プロセス内のメモリとリソースを共有するため、スレッド間のデータ交換は非常に効率的です。しかし、この共有は慎重に管理しなければ、**競合状態(race condition)やデッドロック(deadlock)**といった同期の問題を引き起こす可能性があります。プロセスとは異なり、同一プロセス内の複数スレッドは互いに分離されていません。1つのスレッドが障害を起こすだけで、プロセス全体がクラッシュする可能性があります。
オペレーティングシステムがスレッドとプロセスを管理する方法
- CPUは各時点で、コアごとに1つのタスクしか実行できません。多数のタスクを処理するため、オペレーティングシステムは**プリエンプティブなコンテキストスイッチ(preemptive context switching)**を用います。
オペレーティングシステムはなぜ必ず **プリエンプティブなコンテキストスイッチ(preemptive context switching)**を使う必要があるのでしょうか。
- 答え
すべてのプロセスがCPUを受け取れるようにするため(公平性)
強制しなければ、あるプロセスがCPUを永遠に占有する可能性があります(例: 無限ループ)。
→ 他のプロセスは決して実行されません → 実際には壊れていなくても、システムは「ハング」したように見えます。
while (1) {
    // 作成したプログラムがCPUを決して譲らない
}
OSがCPUを強制的に回収しなければ → それで終わりです。
➡ プリエンプションにより、OSは定期的にCPUを取り戻し(タイムスライス)、他のプロセスと共有できます。
システムの応答性を確保するため(対話性)
オペレーティングシステムは次のものに応答しなければなりません。
- キーボード入力
- マウスクリック
- アプリケーションからの要求
- システムのバックグラウンドタスク
プリエンプティブでなければ、重いアプリケーション(例: 動画レンダリング、AIトレーニング、大きなループ)は、自らCPUを譲らないため、システム全体を固くしてしまいます。
⇒ プリエンプティブな切り替えにより、OSは任意のプロセスを中断し、重要なイベントを優先できます。
優先度の高いプロセスを適時に処理するため(priority scheduling)
一部のプロセスは常に直ちに実行する必要があります。
- Interrupt handler(ハードウェア割り込み処理)
- システムプロセス(kernel)
- リアルタイムタスク(real-time)
- 音声/映像ハンドラ
- Watchdog、security…
OSがCPUを奪取できなければ、実行中の低優先度プロセスが重要な作業を**デッドラインミス(deadline miss)**させます。⇒ プリエンプションは、誰がCPUを占有していても、重要なプロセスを直ちに実行できるようにします。
CPUデッドロックを避け、システムの安定性を高めるため
OSがプロセスの自発的なCPU譲渡(non-preemptive)だけに依存すると、次のものが
- プログラミングのバグ
- ループ
- CPU-boundタスク
- 制御できないユーザー空間プログラム
→ いずれもCPUを「ロック」してしまう可能性があります。
プリエンプションはシステムをより安全にし、故障したプロセスがOS全体を破壊するのを防ぎます。
真のマルチタスク(true multitasking)を支えるため
人間の目にはすべてが「並列」に動いているように見えます。OSがプロセス間を極めて高速に切り替えるからです(1〜10msごと)。
プリエンプションがなければ → コンピュータは一度に1つのプログラムしか実行できず、次のことができなくなります。
- Wordを開きながら音楽を聴く
- コードを書きながらブラウザを動かす
- バックグラウンドプログラム(同期、更新、アンチウイルス)を動かす
- UIアプリケーションを滑らかに動かす
➡ プリエンプティブなコンテキストスイッチは、CPU時間分割によるマルチタスクをシミュレートします。
- コンテキストスイッチの過程で、OSは現在のタスクを一時停止し、その状態を保存し、次のタスクの状態をロードして実行します。この極めて高速な切り替えが、単一のCPUコア上でタスクが同時に実行されているかのような錯覚を生み出します。
- プロセスの場合、オペレーティングシステムが別々のメモリ空間を保存・ロードしなければならないため、コンテキストスイッチはより多くのリソースを消費します。
- スレッドの場合、同一プロセス内で同じメモリ領域を共有するため、コンテキストスイッチはより高速です。しかし、切り替えが頻繁すぎると**オーバーヘッド(overhead)**も発生し、全体の性能を低下させる可能性があります。
- 実際にプロセスが同時に並列実行できるのは、システムに複数のCPUコアがある場合だけです。各コアはそれぞれ別のプロセスを同時に処理できます。
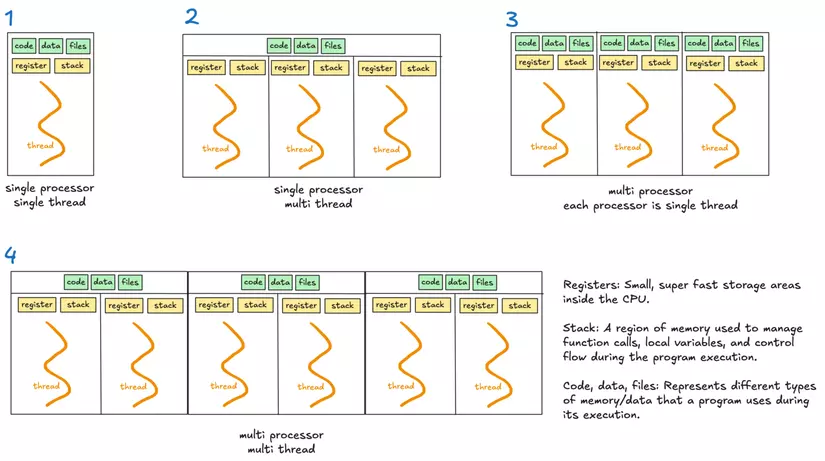
上の図は、次の4つのシナリオを比較しています。
(1) 単一プロセス、単一スレッド – 1つのプロセスに1つのスレッド。
(2) 単一プロセス、マルチスレッド – 1つのプロセスに複数のスレッド。
(3) マルチプロセス、単一スレッド – 複数のプロセスがあり、各プロセスに1つのスレッド。
(4) マルチプロセス、マルチスレッド – 複数のプロセスがあり、各プロセスに複数のスレッド。
(code、data、files の枠は、プログラムが実行時に使用するメモリ領域/データ格納領域を表します。register はCPU内の小型で高速なレジスタです。stack は関数呼び出しやローカル変数などを管理するためのスタックメモリ領域です。)
Multithreading(マルチスレッド)
- Multithreading、すなわちマルチスレッドは、同一プロセス内で複数のタスクを並行に実行できるようにするプログラミング手法です。Pythonでは、ファイルの読み書き、データベースクエリ、ネットワーク接続など、I/O待ちによって遅くなるI/O-boundアプリケーションの性能を改善するためにマルチスレッドが使われます。
- Global Interpreter Lock (GIL): GILはPythonのグローバルロックであり、ある時点で1つのスレッドだけがPythonバイトコードを実行することを保証します。GILはPythonのメモリ管理を単純化するために導入されました。オブジェクト生成などの多くの内部操作は、デフォルトではマルチスレッド実行に対して安全ではないからです。GILがなければ、共有リソースにアクセスする複数のスレッドは、race condition やデータ破損を防ぐために複雑なロックや同期の仕組みを必要とします。これは次を意味します。
- マルチスレッドはCPU-boundタスクには非効率です。GILがスレッドのCPUコア上での同時実行を妨げるためです ⇒ GILがボトルネックになります(GILを奪い合う多数のスレッドは、Pythonバイトコードの実行を交代しなければなりません)
- マルチスレッドはI/O-boundタスクに有用です。あるスレッドがI/Oを待っているあいだ、GILは別のスレッドへ譲ることができます。
- GILのため、Pythonのスレッドは所定の戦略に従ってCPUによって交代実行されます。たとえば、あるスレッドを時間間隔 Δτ のあいだ実行してから別のスレッドへ切り替え、交互に往復します。
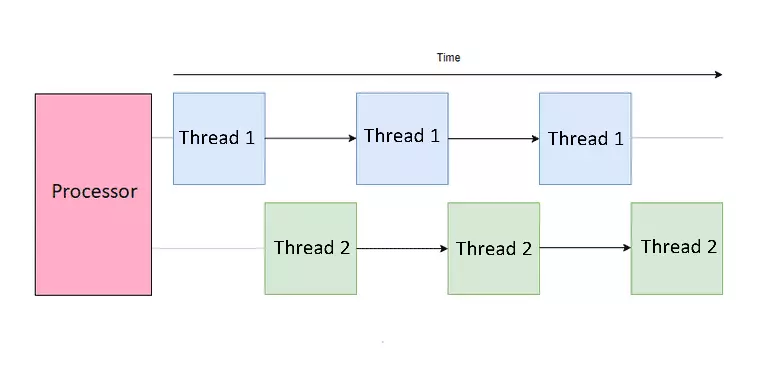
注目すべき興味深いケースのひとつが、time.sleep 関数を使う場合です。Pythonは実際にはこれをI/O操作として扱います。time.sleep 関数はCPUを消費しません。「スリープ」しているあいだ、計算もPythonバイトコードの実行も行わないからです。代わりに、待ち時間の追跡はオペレーティングシステムに委ねられます。スレッドが「スリープ」しているあいだ、GILは解放され、他のスレッドが実行されてPythonインタプリタを使用できます。
スレッド(Thread)とプロセス(Process)
- プロセス(Process): プログラムの実行中インスタンスであり、独自のメモリ空間とリソースを持ちます。
- スレッド(Thread): プロセス内のより小さな実行単位です。同一プロセス内のスレッドは、同じメモリ空間とリソースを共有します。
比較:
- マルチプロセス(Multiprocessing): 各プロセスが独自のGILを持ち、メモリを共有せず、より安全ですがリソース消費は大きくなります。
- マルチスレッド(Multithreading): メモリを共有し、より軽量ですが、データ衝突を避けるために同期管理が必要です。
マルチプロセス(Multiprocessing)
- マルチプロセスは、システムが多数のプロセスを並列に実行できるようにします。各プロセスは独立したメモリ、GIL、リソースを持ちます。その各プロセスの内部には、1つ以上のスレッドが存在し得ます。
- マルチプロセスはGILの制限を克服するのに役立ちます。そのため、多くの計算リソースを必要とするCPU-boundタスクに特に適しています。
- しかし、各プロセスが独自のメモリ空間を持ち、プロセス管理コストも発生するため、マルチプロセスはより多くのリソースを消費します。
Asynchronous
非同期(asynchronous programming)は、各タスクの完了を待たずに次のタスクへ移れるようにすることで、複数のタスクを一度に処理するプログラミング手法です。Pythonでは、特にPython 3.4の asyncio モジュールと、Python 3.5の async および await キーワードの登場以降、非同期は言語の重要な一部となっています。
動作の仕組み Asyncio は、タスクの実行を調整するためにイベントループを動かします。タスクは、ネットワーク応答待ちやファイルの読み取り/処理など、何かを待つ必要があるときに自発的に「一時停止」します。あるタスクが待っているあいだ、イベントループは別のタスクの実行へ切り替え、待ちによるアイドル時間がないようにします。
⇒ このため asyncio は、数千件のWebリクエストの処理やデータベースクエリの管理など、待つことの多い小さなタスクが多数あるシナリオに特に適しています。すべてが単一スレッド上で動くため、asyncioはスレッドを絶えず切り替えるオーバーヘッドと複雑さを避けられます。
- Asynchronous と Multithreading の違い:
- マルチスレッドは、あるスレッドが待っているときにオペレーティングシステムがスレッド間を切り替えることに依存します(プリエンプティブなコンテキストスイッチ)。あるスレッドが待っているとき、OSは自動的に別のスレッドへ切り替えます。
- Asyncioは単一スレッド上で動き、タスク同士の協調に依存します。待つ必要があるときに自ら「譲る」(一時停止する)のです(協調的マルチタスク)。
1. なぜ非同期が必要なのか?
- より高い性能: 非同期により、プログラムは多数のI/Oタスクを同時に処理でき、全体の性能が向上します。
- より速い応答: Webアプリケーションでは、非同期により多数のクライアント要求を遅延なく同時に処理できます。
- 効率的なリソース利用: 多数のスレッドやプロセスを生成することを避け、システムリソースを節約します。
2. 同期と非同期の違い
- 同期: 各タスクは順次実行されます。プログラムは1つのタスクが完了するまで待ってから、次のタスクへ移ります。
- 非同期: 前のタスクの完了を待つあいだに別のタスクへ切り替えられます。通常はI/Oタスクに適用されます。
- Asyncio Module
asyncio は、coroutine を用いた非同期プログラミング(asynchronous programming)のサポートを提供するPythonライブラリです。Python 3.4から導入され、asyncioは非同期コードを容易かつ効率的に書けるようにします。
以下は asyncio のいくつかの構成要素です。
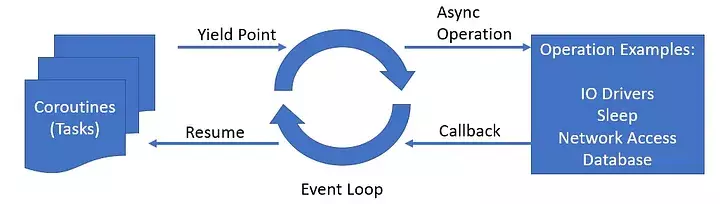
3.1. Coroutines
Coroutine は、自身の実行を一時停止し、制御を event loop へ戻すことができる関数であり、それにより event loop は他の coroutine を実行できます。Pythonでは、coroutine は async def キーワードで定義されます。await を使って、await の後の式が完了するまで現在の coroutine を一時停止します。
Coroutines は呼び出されたときに自動では実行されません。await、asyncio.run()、asyncio.gather() を通じて event loop によって実行されるか、task へ変換される必要があります。
3.2. Tasks
task は coroutine を包み、event loop 内で実行するようスケジュールするオブジェクトです。await 地点でコンテキストを切り替えることにより、同じ event loop 内で複数の coroutine を並行に実行できます。
Tasks の作成と実行方法:
task = asyncio.create_task(my_coroutine())
Task を作成すると、それは event loop に追加され、event loop が実行されると実行を開始します。また、asyncio.gather() のような関数を使って、多数の task を並行に実行し、その結果を待つこともできます。
3.4. Futures
Future は、将来得られる結果を表すオブジェクトです。asyncioでは、Future は通常、まだ完了していない非同期操作の結果を表すために使われます。
Future の使い方:
- Future の作成: 通常、Futures は event loop と低レベルAPIによって作成・管理されます。
- Future を待つ: Future を await して、その結果を待つことができます。
- Future の完了: Future は set_result() または set_exception() を呼び出して完了できます。
future = loop.create_future()

# コードのどこかで Future を完了させる
future.set_result('Result')

# Future の結果を待つ
result = await future
3.3. Event Loop
Event Loop は asyncio の中心です。coroutine の実行の管理と調整、I/Oの管理、スケジュールされたイベントの処理を担う無限ループです。
Event Loop の動作:
- 開始と管理:
asyncioプログラムを起動すると、event loopが作成される(または現在のevent loopが取得される)し、実行を開始します。 CoroutinesとTasksの調整: Event loop は実行が必要なcoroutineとtasksのリストを管理します。- 非同期I/Oの処理: I/Oイベントやタイマーの発生を待ち、対応するコールバックを起動します。
- コンテキストの切り替え:
coroutineがawait地点で一時停止すると、event loopは待機中の別のcoroutineの実行へ切り替え、CPU時間を効率よく使います。
非同期コードの2つの書き方
await coroutine
- 意味:
- coroutine を実行し、完了するまで待つ。
- 終わるまで他の作業へ切り替えません。
- 特徴
- 逐次的(sequential)
- 非同期フローは
await地点でブロックされます - coroutine の結果は
awaitの戻り値です
result = await foo() #2s
# → foo() が終わって初めて、次の行が実行されます。
asyncio.create_task(coroutine)
- 意味
- coroutine を並行(concurrent)に実行する task を作成する。
- coroutine の完了を待たない → すぐに続行します。
- 特徴
- バックグラウンドで実行されます(background task)
- Task はスケジューラによって管理され、他の coroutine と並行に実行されます
- 結果を得るには、後で task を
awaitする必要があります
task = asyncio.create_task(foo())
# すぐに他の作業を続ける
...
result = await task  # 必要なら結果を待つ

tasks = [
    asyncio.create_task(foo()), #2s
    asyncio.create_task(foo()), #2s
    asyncio.create_task(foo()), #2s
] # coroutine を並行に実行する

results = await asyncio.gather(*tasks) #合計 2s
| 特徴 | await coroutine | create_task(coroutine) |
|---|---|---|
| coroutine の実行を開始する | ✔ | ✔ |
| coroutine の完了を待つか? | ✔ 必須 | ❌ 待たない |
| coroutine を並行実行するか? | ❌ しない | ✔ する |
| 実行の種類 | 逐次 | 並行(concurrent) |
| スケジューラが task を管理するか? | ❌ Task ではない | ✔ Task である |
| 戻り値 | coroutine の結果 | Task オブジェクト |
| 使う場面 | その coroutine から結果が必要なとき。 | |
| 作業が逐次的な性質を持つとき。 | ||
| 実行順序が重要なとき。 | coroutine を並行に実行し、非同期フローをブロックしたくないとき。 | |
| バックグラウンドジョブを実行するとき。 | ||
| 多数の coroutine を同時に実行するとき。 |
その他の重要な点
同じプログラムのなかで同期コードと非同期コードを組み合わせることができます。同期コードはプログラムをブロック(blocking)するため、asyncio.to_thread() によって別スレッドへ移すことができます。この方法により、プログラムは実際にマルチスレッドで動きます。次の例では、asyncio のイベントループがメインスレッド上で動き、別のバックグラウンドスレッドが sync_task(仮想の同期関数)の実行に使われます。
import asyncio
import time

def sync_task():
    time.sleep(2)
    return "Completed"

async def main():
    result = await asyncio.to_thread(sync_task)
    print(result)

asyncio.run(main())
CPU-bound(CPUを多く使う)タスクも、別のプロセスへ移すべきです。
どの並行モデルをいつ使うべきか?
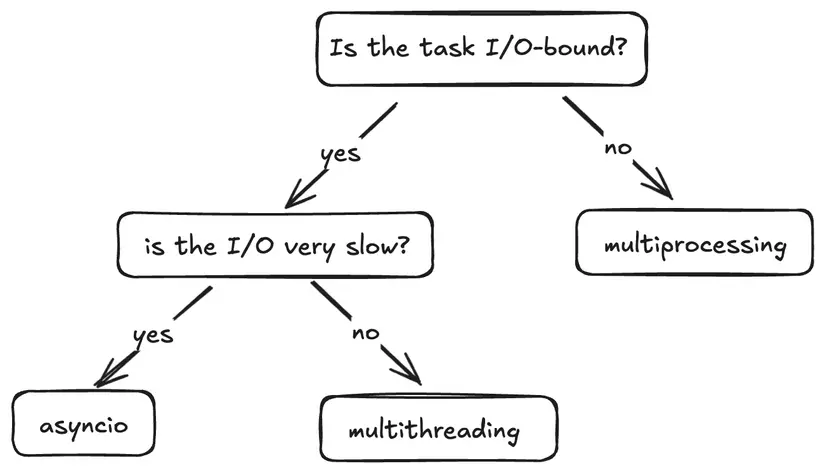
タスクがI/O-boundではない(つまりI/Oによって制限されない)場合は、マルチプロセスを使います。タスクがI/O-boundであれば、I/Oの速度を見てください。I/Oが非常に遅いならAsyncioを、それほど遅くないならマルチスレッドを使います。
- マルチプロセス:
- 多くの計算を必要とするCPU-boundタスクに最も適しています。
- GILを回避する必要があるとき — 各プロセスが独自のPythonインタプリタを持ち、真のマルチコア並列を活用できます。
- マルチスレッド:
- コンテキストスイッチの頻度が低く、Pythonインタプリタが1つのスレッド上により長く留まる傾向があるため、速いI/O-boundタスクに最適です。
- GILの影響があるため、CPU-boundタスクには理想的ではありません。
- Asyncio:
- 待ち時間を非常に効率よく管理し、プログラムのスケーラビリティを高めるため、遅いI/O-boundタスク(例: 長時間のネットワークリクエストや遅いデータベースクエリ)に理想的です。
- 作業を別プロセスへ移さない限り、CPU-boundタスクには適しません。
執筆 Huỳnh Phước Nguyên
AIエンジニア、BK Hightech