1. Introduction
Tokenization の本質
自然言語処理(Natural Language Processing - NLP)の世界では、人間とコンピュータのあいだにある最大の障壁のひとつが、情報の受け取り方です。人間はテキストを、文字・語・文脈の連続した流れとして読み理解し、意味は経験と抽象的思考を通じて内挿されます。対照的に、機械学習モデルと人工知能は、生テキスト(raw text)の列に対して完全に盲目です。従来のニューラルネットワークから最先端の Transformer アーキテクチャに至るまで、その中核アーキテクチャは、数値行列と数学的ベクトルだけを受け取り、計算できます。この認識の溝を埋めるための、最初で、最も基本的で、最も決定的な前処理ステップこそが Tokenization です。
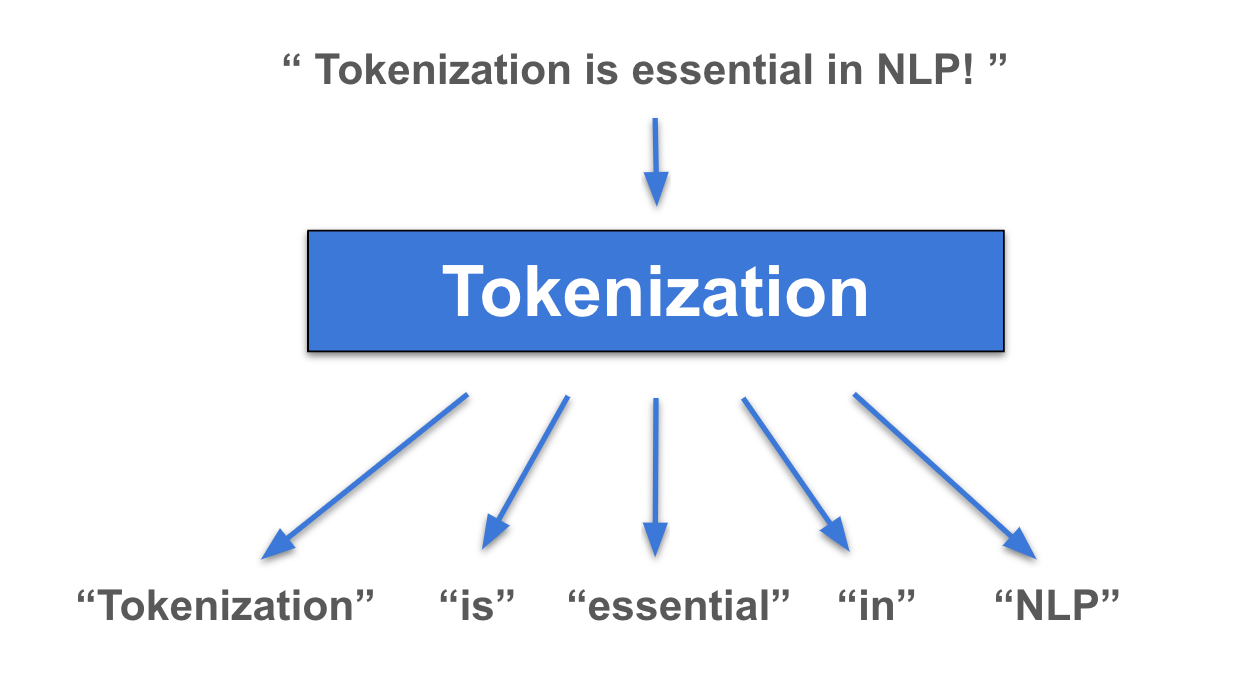
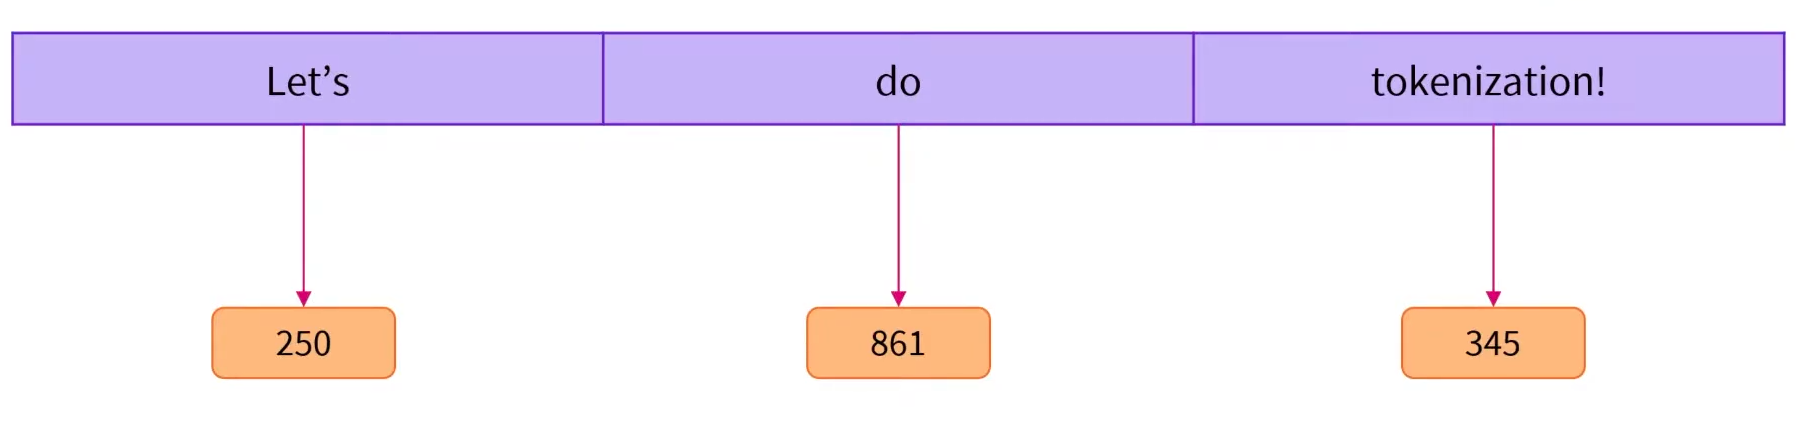
直観的でわかりやすく言えば、Tokenization とは生テキストを解剖し、管理可能なより小さな断片 — 「token」と呼ばれるもの — に分割する過程です。これらの断片は単一の形式に限定されません。完全な語、語の一部(接頭辞、接尾辞、語根 — いわゆる subword)、あるいは言語を構成する個々の文字ですらあり得ます。この過程の究極の目的は、多義的で複雑な言語メッセージを、離散的な要素の配列へ変換することです。分割のあと、各一意の token はシステムの「辞書」(vocabulary)と照合され、一意の識別番号(ID)が割り当てられます。これらの番号から、コンピュータはそれらをベクトル空間(embedding space)へ写像し、意味関係の学習を始められます。
学術的・専門的な技術環境では、基盤概念を明確に区別することが、正確なシステム設計に不可欠です。学習者は、しばしば混同される3つの用語 — Token、Type、Term — の違いを十分に理解する必要があります。
- 「Token」は、あるテキスト断片のなかに現れる具体的な物理的実体です。
- 「Type」は、まったく同じ文字列を共有するすべての tokens を含むクラスを表します。
- 「Term」は、正規化(たとえばすべてを小文字へ変換し、形態的変異を除去する)を経て、情報システムの辞書に正式に格納された type です。
例として、古典的引用 "to sleep perchance to dream" を考えると、このテキストには合計5つの別個の tokens が含まれます。しかし token "to" が2回現れるため、types は4つだけです。システムが分類上あまり意味を持たないストップワード(stop word)として "to" を除去すると決めた場合、最終的な辞書に残る中核 terms は3つだけです。"sleep"、"perchance"、そして "dream" です。
NLP Pipeline における Tokenization の重要性
基本的な感情分類から、数十億パラメータを持つ大規模言語モデル(Large Language Models - LLMs)の事前学習に至るまで、あらゆる NLP パイプライン(処理連鎖)の成否は、Tokenization 戦略の質によって非常に大きく決まります。どれほど優れた AI アルゴリズムであっても、意味を歪めて分割されたテキスト入力を埋め合わせることはできません。この重要性は、次の3つの構造的側面ではっきりと現れます。
第一に、Tokenization は Vocabulary Size(語彙サイズ)を決めることを通じて、入力データ空間の大きさと幾何学を直接形づくります。素朴な単語分割手法は、まれな token や誤字を含む数百万規模の巨大な辞書を作り出すことがあります。これは埋め込み行列の次元爆発を招きます。典型例として過去には、Transformer XL が空白と句読点に基づく単語分割を用いたとき、267,000語に達する辞書を抱えなければなりませんでした。その結果、モデルは入力層と出力層に極めて巨大な埋め込み行列を持ち、時間計算量と計算メモリの双方が指数関数的に増大しました。Tokenization の進化のおかげで、今日の現代的な transformer モデルは、50,000 token を超える辞書を必要とすることはまれでありながら、包括的な言語表現能力を確保しています。
第二に、Tokenization は Out-of-Vocabulary(OOV)問題を解決し、機械学習モデルの汎化(Generalization)能力を高める鍵です。現実世界では、新しいスラング、入力ミス、複雑な形態的変異とともに、言語は絶えず変化します。システムが完全な語だけを認識するなら、訓練データに一度も現れなかった語の前で完全に麻痺します。語彙を形態的に意味のある subword へ分割することで、Tokenization はモデルが基本単位を再結合してまったく新しい語の意味を理解できるようにし、それにより現実のノイズの多いデータ環境でもシステムの安定性を維持します。
第三に、Tokenization は情報伝達の効率と入力系列長(Sequence Length)に直接影響します。Transformer アーキテクチャは、token 系列長 に対して二次の計算量 を持ちます。Tokenization がテキストを細かく切りすぎる(たとえば文字単位)と、入力系列は途方もなく長くなり、GPUメモリを枯渇させ、文中の長距離依存(long-range dependencies)をモデル化する能力を低下させます。逆に粗く切りすぎると、意味情報は詰め込まれすぎて分析が難しくなります。理想的な均衡点を見出すことこそ、この前処理ステップの核心的な技術です。
データ変換過程の可視化
学習者がデータの変容をできるだけ詳しく想像できるよう、生テキストからコンピュータが吸収できる形式への変化を示す実際の例を見てみましょう。
次の入力テキストを考えます。"Don't you love Transformers? We sure do."。
最も原始的な空白分割を適用すると、得られる結果は次の配列です。
["Don't", "you", "love", "🤗", "Transformers?", "We", "sure", "do."]
一見すると、この結果は妥当に見えます。しかし意味分析の観点では、致命的な欠陥を露呈します。"Transformers?" や "do." のような token が疑問符やピリオドとくっついています。これは、モデルが句読点のない "Transformer" と句読点付きの "Transformers?" をまったく別の実体として扱うことを意味し、辞書メモリを浪費し、ベクトル空間を乱します。
洗練された現代的な Tokenization パイプラインは、上の文をより鋭く処理します。文法規則を認識し、句読点を分離し、絵文字を保持し、省略形を処理します。
完全な Tokenization 系列は、テキストを次のように分解します。
["Don", "'", "t", "you", "love", "🤗", "Transformers", "?", "We", "sure", "do", "."]
最後に、システムはこの配列を内部辞書と照合し、識別子の系列(Input IDs)へ変換します。この過程のレンズを通すと、複雑な感情の色合いを持つ英語の文は、深層ニューラルネットワークへ送る準備のできた、コンパクトな数学的テンソルへ凝縮されます。絵文字(emoji)はゴミ文字として捨てられるのではなく、独立した感情的価値を持つ token として尊重され、モデルの感情分析能力に寄与します。
2. Core Component
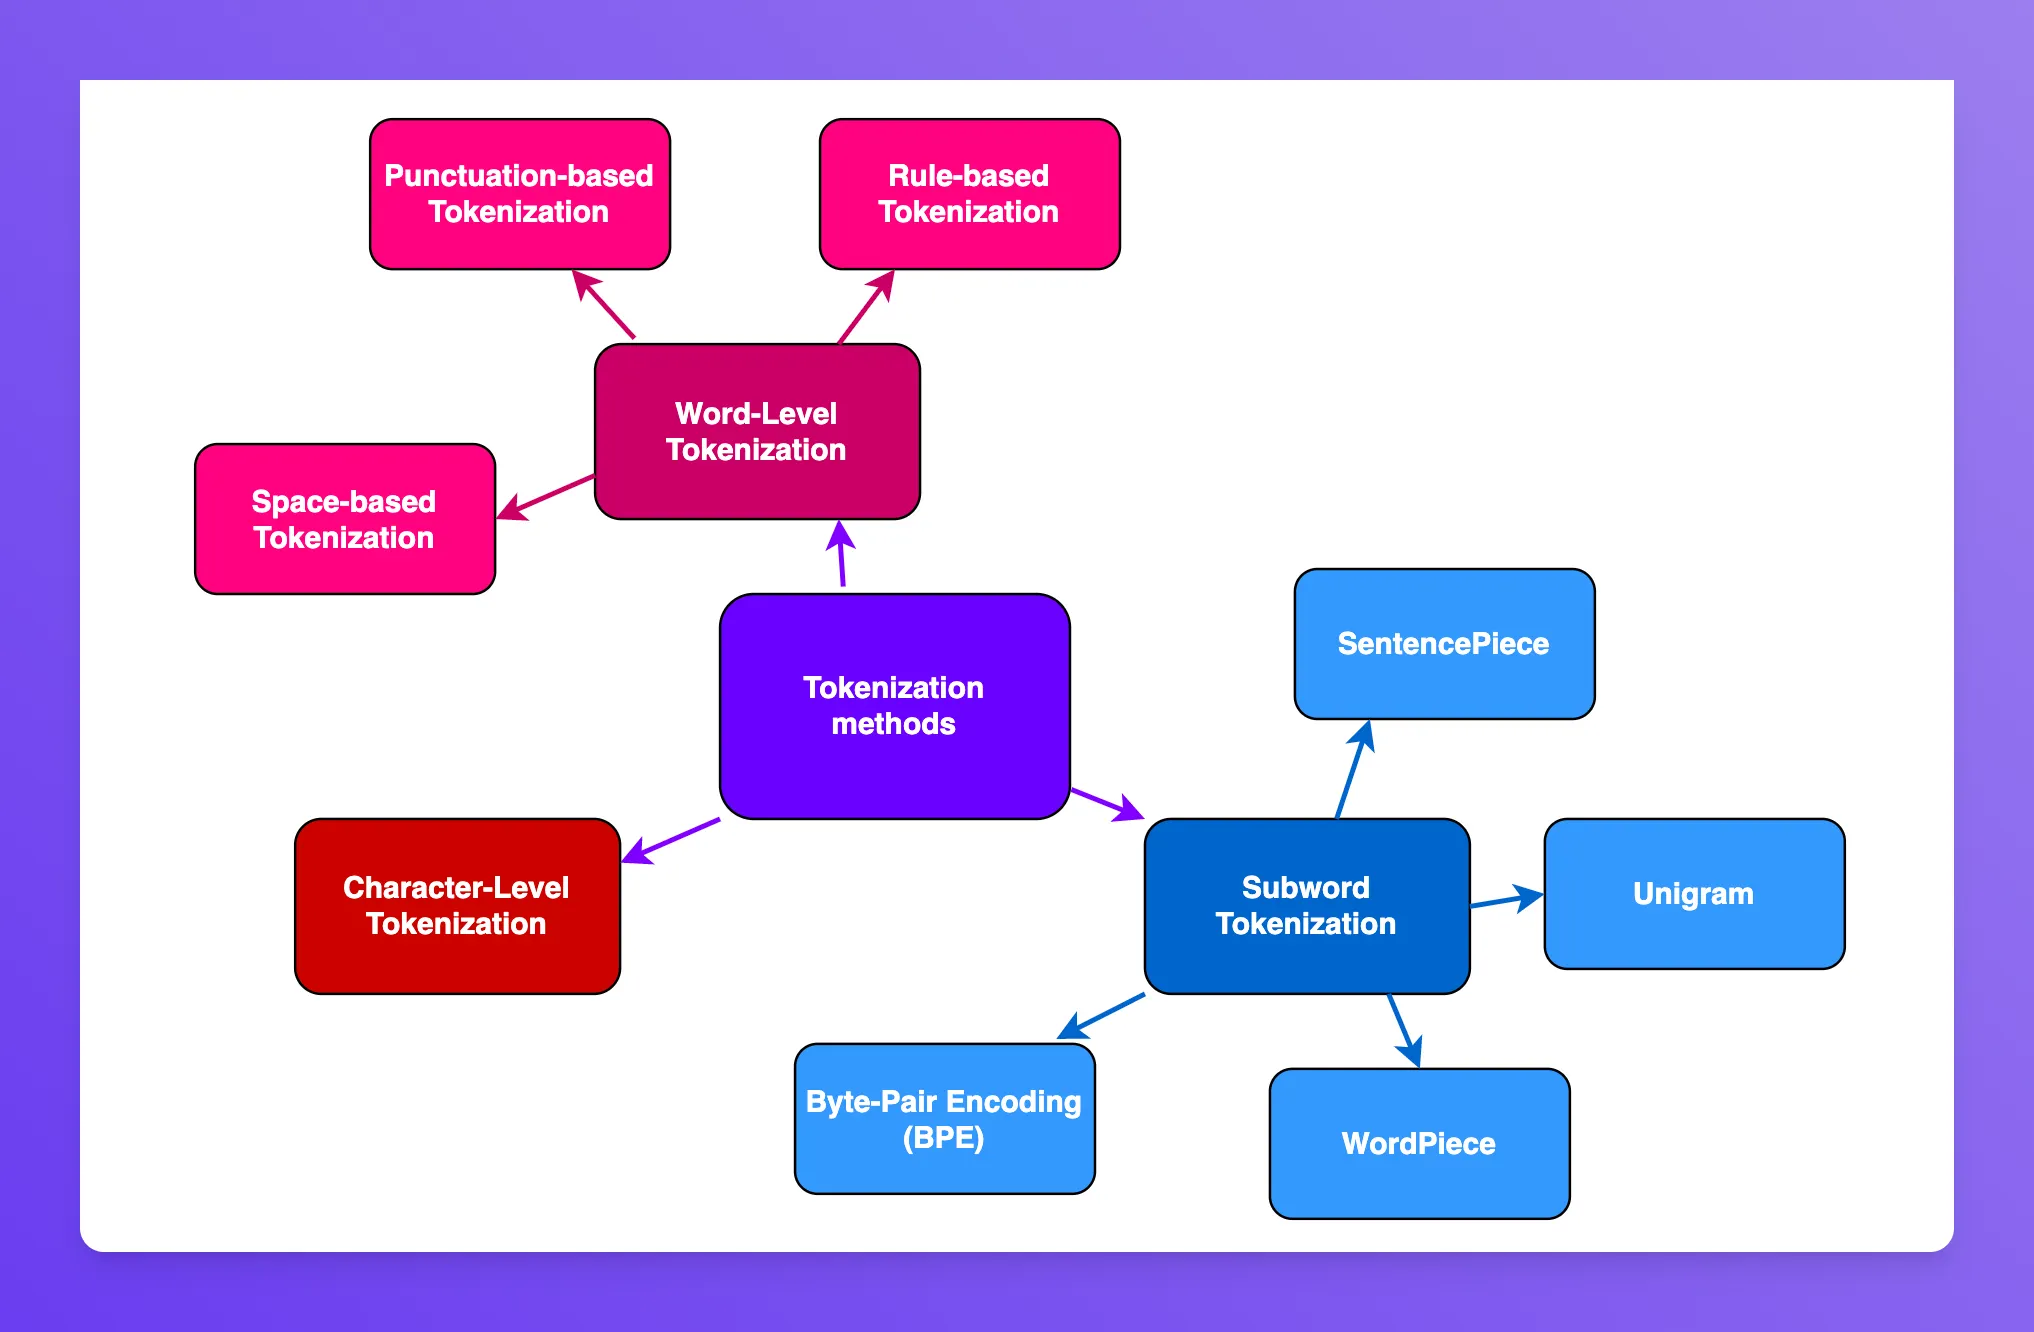
コンピュータ科学全般、そして NLP の発展は、多くの Tokenization 戦略の誕生、競争、淘汰を見てきました。各戦略は前世代の行き詰まり、とくに言語の多様性とハードウェア資源の限界の均衡という問題を解決するために生まれました。システムを掌握するには、学習者は動作メカニズムを深く理解し、以下の3つの中核的 Tokenization 学派の長所と短所を多次元的に分析する必要があります。
2.1. Word-level Tokenization(自然な境界に基づく単語分割)
名前のとおり、Word-level Tokenization は人間の思考にとって最も自然な方法でテキストに接近します。テキストにすでに存在する物理的境界、主に空白(whitespace)と句読点(punctuation)を切れ目として使います。これは NLP の黎明期を支配した手法であり、今日でも小規模アプリケーションでは価値を保っています。
この手法のメカニズムは比較的直観的です。入力列を受け取ると、アルゴリズムはスペース、タブ、改行文字を含むすべての位置で列を走査し、切断します。より複雑な版(Rule-based tokenization や Regular Expressions の利用など)では、カンマやピリオドを分離し、英語の一般的な省略形を処理するための追加規則がプログラムされます。
しかし、この単純さは大規模展開や多様なデータでは深刻な限界をもたらします。Word-level の最大の利点は、形態構造を壊さずに各語の包括的な意味を保持できることと、計算コストが極めて低く、インフラ水準で容易に展開できることです。その一方で、欠点は深層モデルにとって破壊的です。
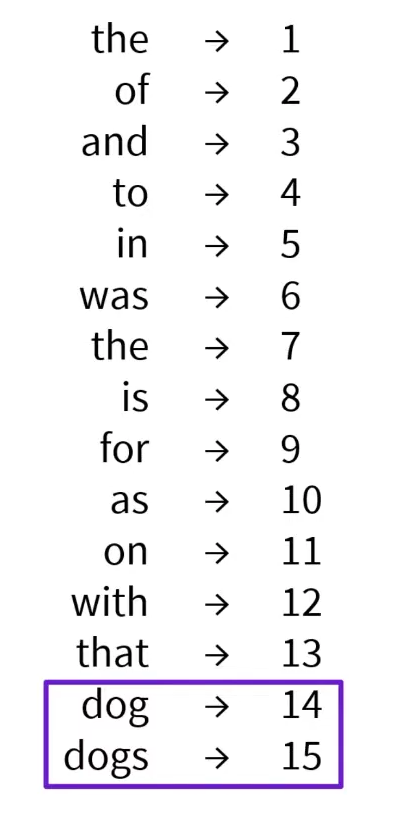
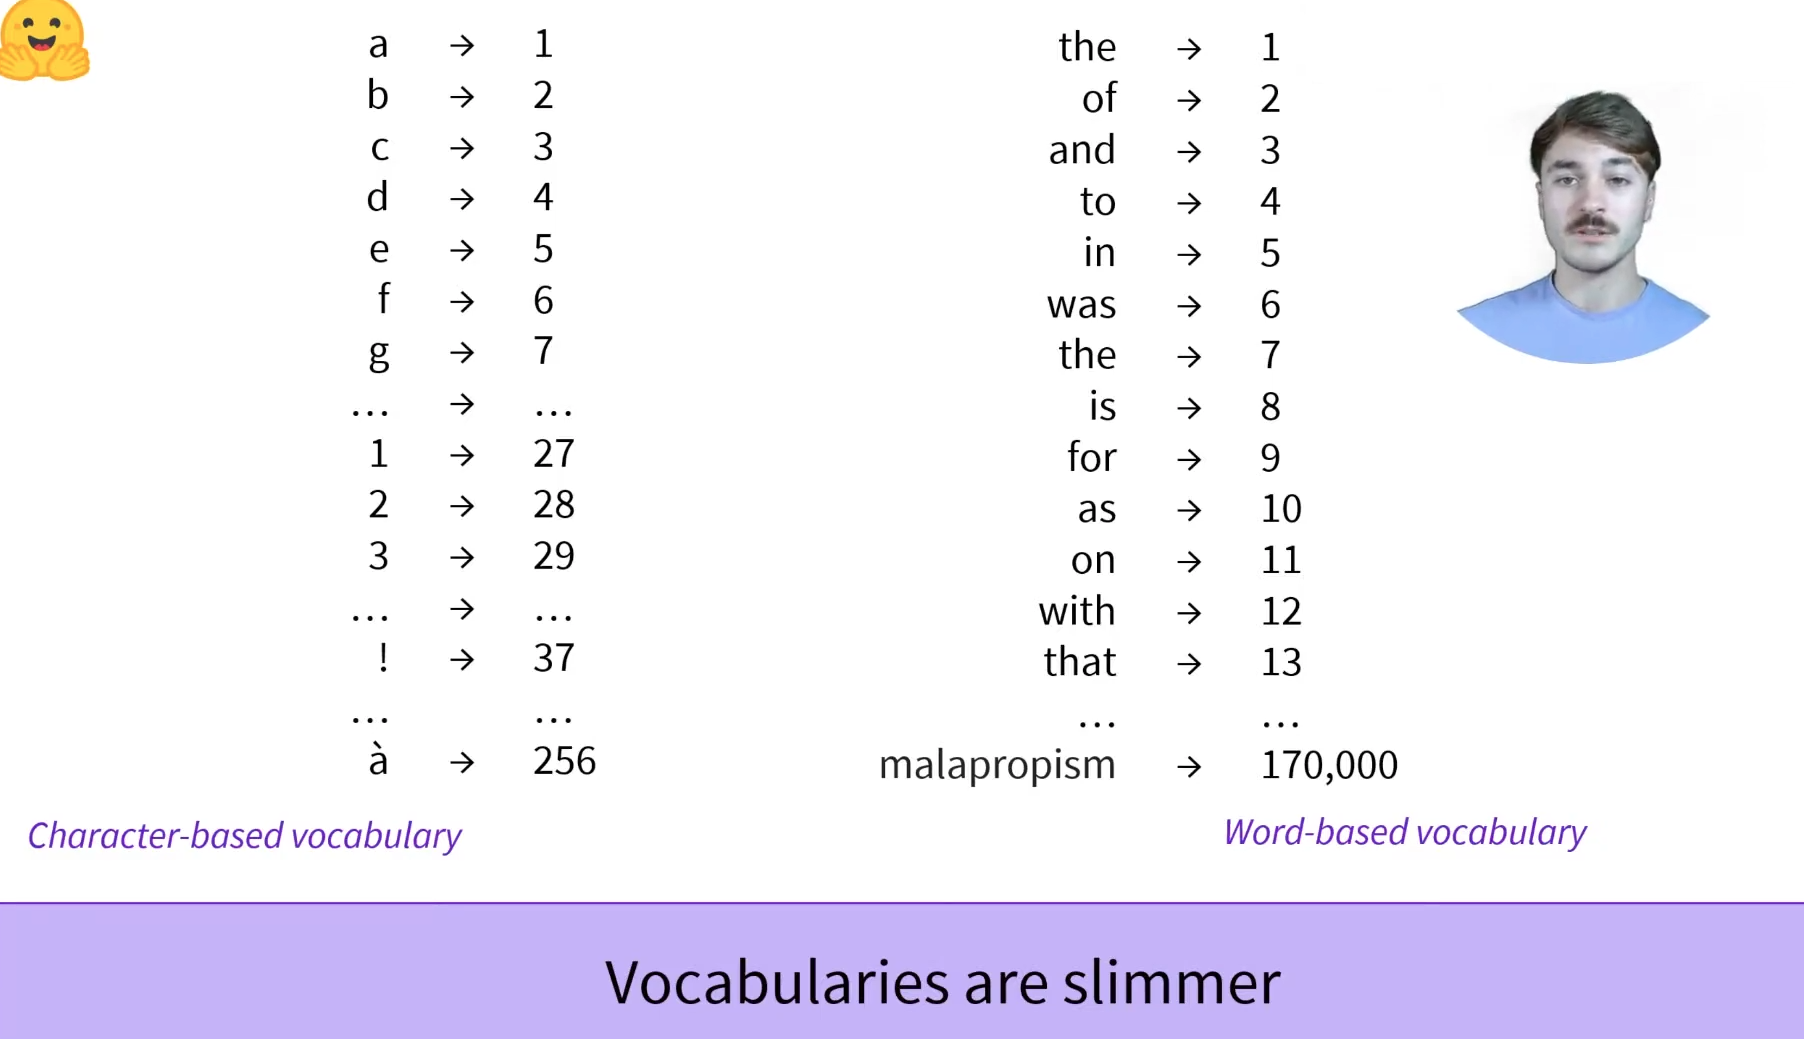
まず、この手法は Vocabulary Explosion を直接引き起こします。どの言語でも、接頭辞・接尾辞の組み合わせと人間の言語創造性により、語彙の数は無限です。ある語の各変異(例: "run"、"runs"、"running"、"ran")が独立した token と見なされれば、辞書サイズは制御不能に膨張し、数十万をはるかに超えます。これは重み行列のメモリに巨大な圧力をかけます。
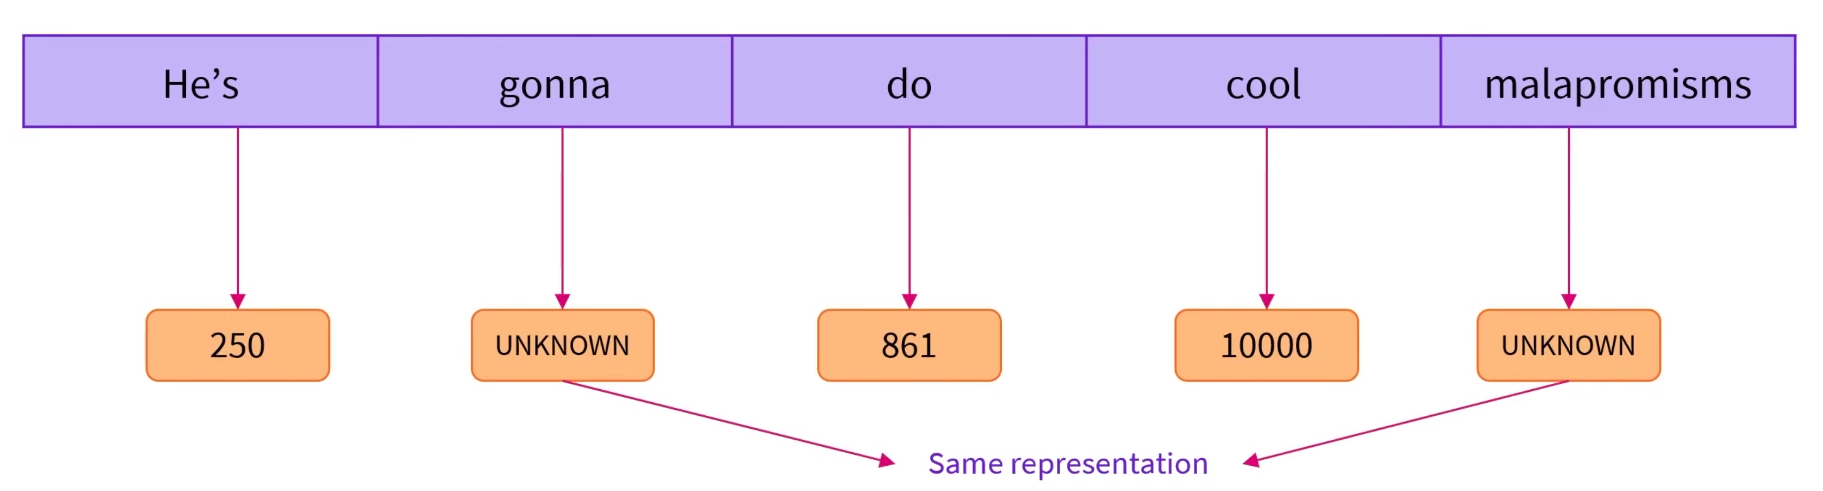
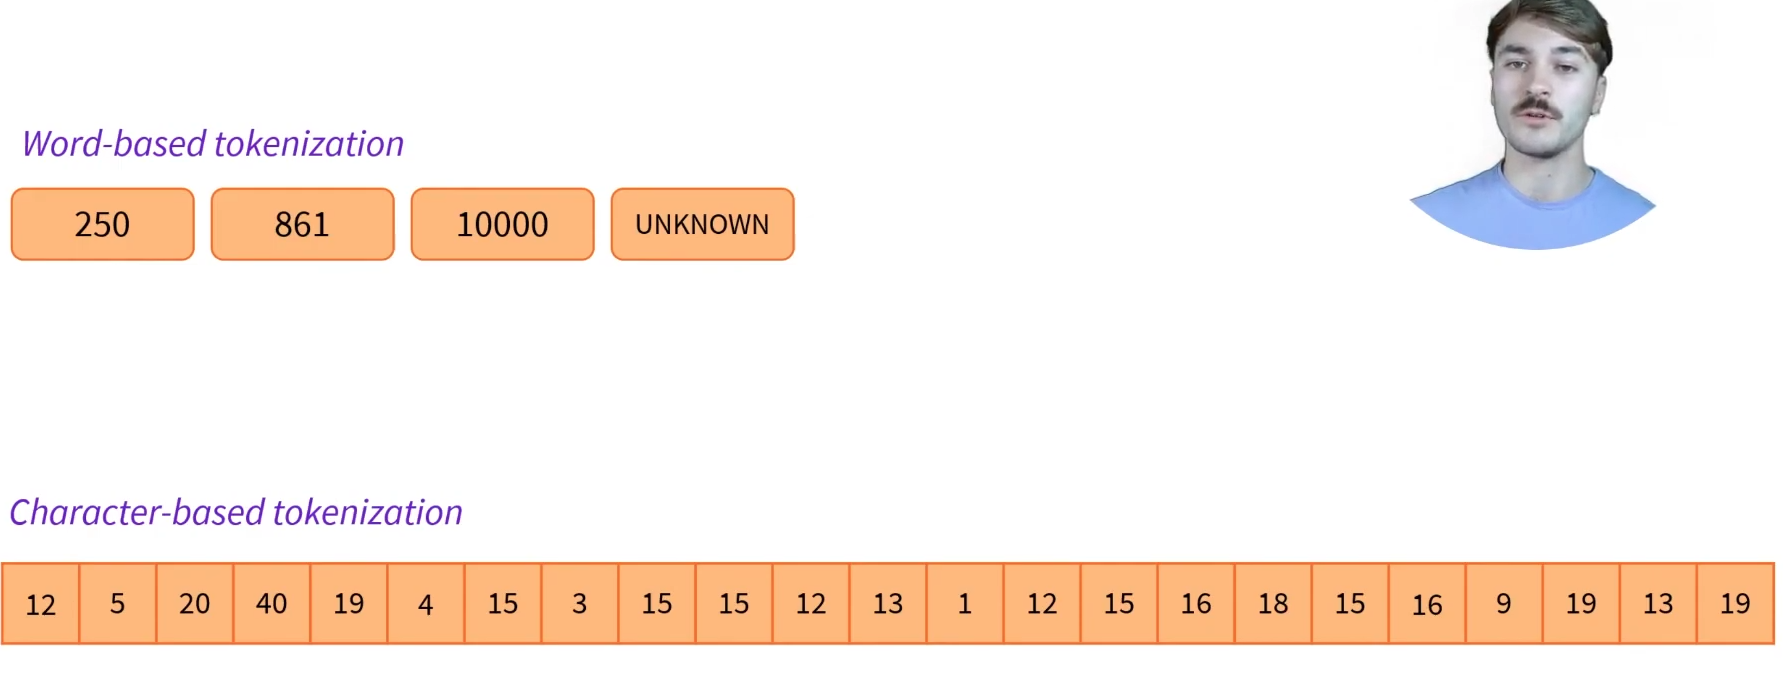
第二の直接的帰結は Out-of-Vocabulary(OOV)問題です。入力ミス、ソーシャルメディアのスラング、新たに現れた専門用語を含むデータに直面すると、Word-level Tokenizer は完全に無力になり、それらに <UNK>(Unknown — 未知)ラベルを割り当てざるを得ません。<UNK> token の密集した出現はモデルを盲目にし、文脈推論の能力を奪います。この手法は完全に失敗し、テキストの意味を完全に破壊します。
2.2. Character-level Tokenization(基本的な文字分割)
OOV という悪夢と辞書メモリの爆発を徹底的に解決するため、研究界はまったく反対の極へ進みました。Character-level Tokenization です。この手法はテキストを最も微視的な水準まで分解し、各単独文字(アルファベット文字、数字、記号、句読点)を独立した token と見なします。
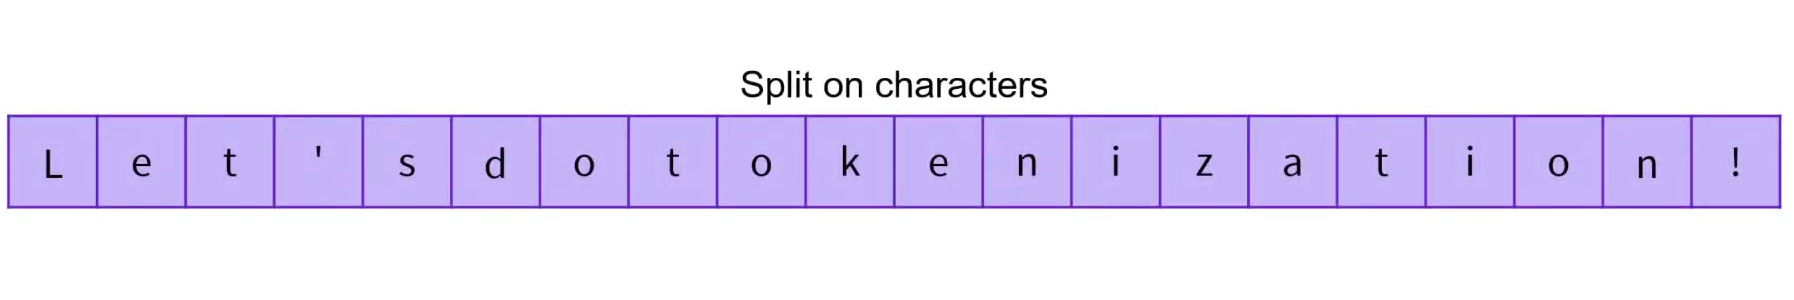
このメカニズムは比類のない利点をもたらします。辞書サイズは最小まで縮小され、ほとんどの言語では通常わずか数百 token 程度です(サポートされる Unicode 符号化に依存します)。さらに重要なのは、OOV 問題が完全に消滅することです。どんな奇妙な語や綴り誤りも基本文字から構成されるため、コンピュータは常にそれらを有効な ID 列として表現できます。
しかし、このメモリ最適化の代償は、意味能力と計算性能の犠牲です。最大の欠点は局所的意味の喪失(Loss of Word Meaning)です。単独で立つ文字 "a" や "b" は、いかなる語彙的意味も持ちません。これらの無意味な文字を意味ある構造へつなぐ責任は、機械学習モデルの隠れ層へ完全に押し出されます。モデルはより深くなり、より多くのデータを必要とし、文字の並び "a-p-p-l-e" が組み合わさってりんごになることを自ら学ぶために、より長い収束時間を要します。
加えて、Character-level は巨大な長さの入力系列を生み出します。わずか20語の文が、100を超える文字 token の系列になり得ます。概観で述べたとおり、Transformer アーキテクチャに基づくモデルでは、計算コストは系列長 とともに指数関数的に増加します。過度に長い系列をモデルへ入れることは推論速度を落とすだけでなく、GPU の VRAM を急速に枯渇させ、長いテキスト処理を要するタスクではこの手法を適用できなくします。
2.3. Subword-level Tokenization
上記2手法の内在的限界を認識し、AIアーキテクトは Subword-level Tokenization を創出しました。これは完全な妥協の設計哲学であり、GPT、BERT、T5 といった LLM の台頭の背骨となっています。この手法の哲学は、頻出語彙は完全なまま保存し、まれな語は形態的意味を持つ構成要素(subword)へ分解することです。
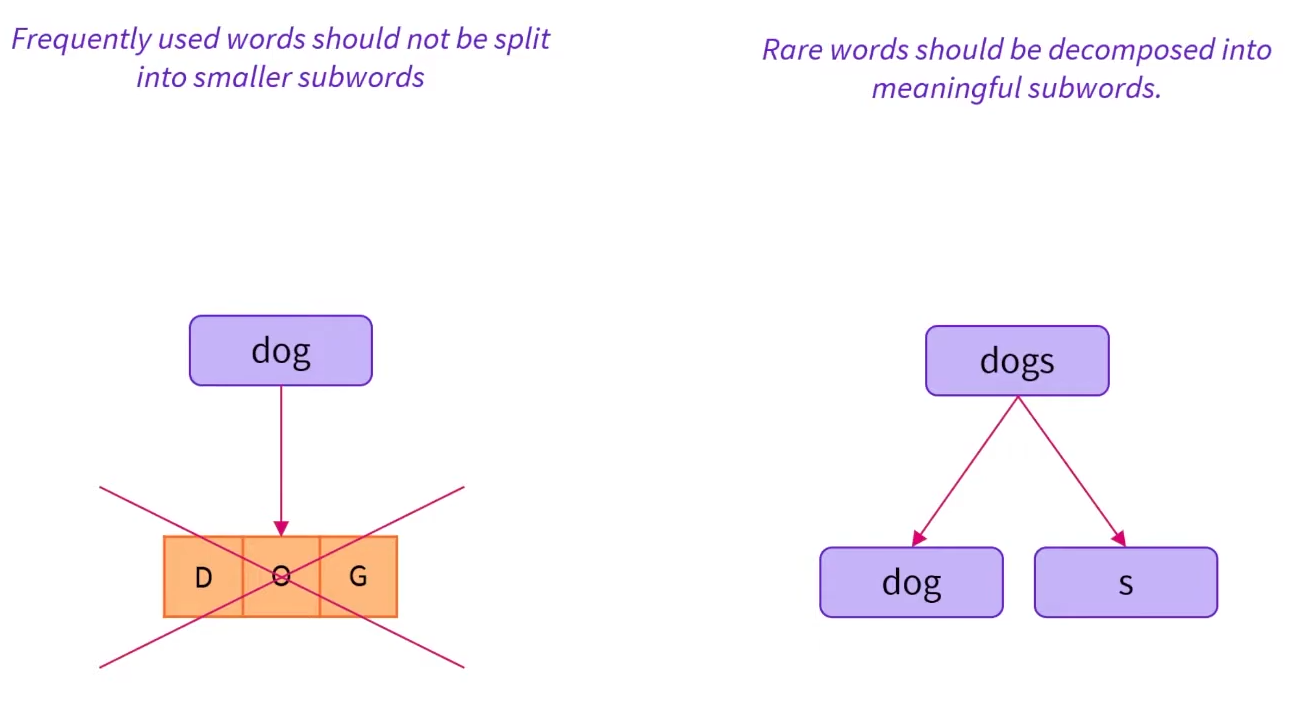
この戦略により、辞書サイズは最適な水準(通常 30,000 から 64,000 token のあいだ)で厳密に制御されます。効率よく計算できるほど小さく、かつテキストを過度に長い系列へ変えないほど大きいのです。未出現の語(OOV)は無意味な <UNK> にはならず、モデルは接頭辞(prefix)、語根(root)、接尾辞(suffix)を組み立てることで解釈します。
学習者が深く把握できるよう、以下では現在最も現代的で強力な3つの Subword アルゴリズムを詳しく分析します。
A. Byte Pair Encoding (BPE)
Byte-Pair Encoding (BPE) は、論文 Neural Machine Translation of Rare Words with Subword Units(Sennrich ら、2015)で紹介されました。BPE は訓練データ(training data)を語へ分割するために pre-tokenizer(事前トークナイザ)に依存します。pre-tokenization の過程は、GPT-2 や RoBERTa のように空白に基づく分割(space tokenization)ほど単純でもあり得ます。より高度な pre-tokenization 手法には、規則に基づく分割(rule-based tokenization)があります。たとえば XLM、FlauBERT(ほとんどの言語に Moses ツールを使用)、あるいは GPT(spaCy と ftfy を使用)であり、訓練コーパス(training corpus)における各語の出現頻度を数えます。
pre-tokenization のあと、一意の語(unique words)の集合が作られ、訓練データにおける各語の出現頻度も確定されます。次に BPE は、その一意語集合に現れるすべての記号(symbols)からなる base vocabulary(基礎語彙)を作り、その後2つの base vocabulary 記号から新しい記号を作る merge rules(結合規則)を学習します。この過程は、語彙が望ましいサイズ(desired vocabulary size)に達するまで繰り返されます。望ましい語彙サイズは、tokenizer の訓練を始める前に決めておく必要がある hyperparameter(ハイパーパラメータ)であることに注意してください。
例として、pre-tokenization のあと、次の語集合とその出現頻度が確定されたとします。
("hug", 10), ("pug", 5), ("pun", 12), ("bun", 4), ("hugs", 5)
したがって、base vocabulary(基礎語彙)は ["b", "g", "h", "n", "p", "s", "u"] です。すべての語を base vocabulary に属する記号へ分割すると、次のようになります。
("h" "u" "g", 10), ("p" "u" "g", 5), ("p" "u" "n", 12), ("b" "u" "n", 4), ("h" "u" "g" "s", 5)
BPE アルゴリズムはその後、可能な各記号対(symbol pair)の頻度を数え、最も頻繁に現れる対を選びます。上の例では、"h" のあとに "u" が続く出現は 10 + 5 = 15 回です("hug" の10回の出現で10回、"hugs" の5回の出現で5回)。しかし、最も多い記号対は "u" のあとに "g" が続くもので、合計 10 + 5 + 5 = 20 回です。したがって、tokenizer が学習する最初の merge rule は、記号 "g" の直前に来るすべての記号 "u" をまとめることです。次に "ug" が vocabulary(語彙集合)へ追加されます。そのときの語集合は次のようになります。
("h" "ug", 10), ("p" "ug", 5), ("p" "u" "n", 12), ("b" "u" "n", 4), ("h" "ug" "s", 5)
BPE は次に最も一般的な記号対を特定し続けます。それは "u" のあとに "n" が続くもので、16回現れます。"u" と "n" は "un" へ結合され、vocabulary に追加されます。次に多い記号対は "h" のあとに "ug" が続くもので、15回現れます。再びこの対は結合され、"hug" が vocabulary に追加されます。
この段階で、vocabulary は ["b", "g", "h", "n", "p", "s", "u", "ug", "un", "hug"] であり、一意語の集合は次のように表されます。
("hug", 10), ("p" "ug", 5), ("p" "un", 12), ("b" "un", 4), ("hug" "s", 5)
Byte-Pair Encoding (BPE) の訓練がこの時点で止まると仮定すると、学習済み merge rules はその後、新しい語へ適用されます(それらの新しい語が base vocabulary にまだない記号を含まない限り)。たとえば、語 "bug" は ["b", "ug"] に tokenize されますが、"mug" は記号 "m" が base vocabulary にないため ["<unk>", "ug"] に tokenize されます。一般に、"m" のような単独文字は通常 "<unk>"(unknown — 未知)記号で置き換えられません。訓練データは通常、各文字を少なくとも1回含むからです。しかしこれは絵文字(emojis)のような特殊文字では非常に起こりやすくなります。
先に述べたとおり、語彙サイズ(vocabulary size)— すなわち base vocabulary のサイズ + 結合(merges)の回数 — は選択すべき hyperparameter です。たとえば GPT の語彙サイズは 40,478 です。478 の基礎文字を使い、40,000 回の結合のあと訓練を止めると決めたからです。
B. WordPiece
Google が開発し、BERT モデルの成功によって世界的に有名になった WordPiece は、BPE と同じ哲学的基盤を共有しつつ、より最適な数学的洗練を内に持っています。
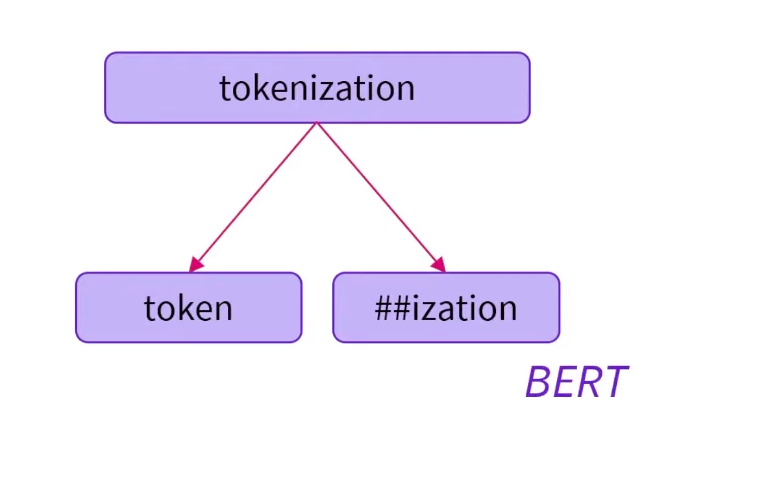
中核的な違いは、結合の選択基準にあります。BPE が生の頻度カウント(raw frequency)だけに依拠するのに対し、WordPiece は確率論を適用します。その対が結合されたときに訓練データ全体の尤度(Likelihood)を最大化する文字対を計算し、選択します。具体的には、2文字が完全に独立して立つ場合の確率と比較して、結合対の確率を評価します。これにより WordPiece は、より音声的・形態的な分割決定を行えます。
WordPiece の識別的特徴は、特殊な接頭辞記号(通常は ##)を使い、subword が直前の語に付けられる補助成分であることを示すことです。複雑な固有名詞や新造語は、WordPiece によって ["pro", "##per", "##noun"] として巧みに表現され得ます。実装の実務では、WordPiece は形態的変異、創造的綴り、多言語文脈を卓越してカバーし、旧来の手法に比べて OOV token の数を大幅に減らすことが示されています。
C. Unigram Language Model Tokenization
Unigram は、論文 Subword Regularization: Improving Neural Network Translation Models with Multiple Subword Candidates(Kudo、2018)で紹介された subword tokenization(部分語トークン化)アルゴリズムです。BPE や WordPiece とは対照的に、Unigram は多数の記号で base vocabulary(基礎語彙)を初期化し、記号を段階的に削減してより小さな vocabulary(語彙)を得ます。たとえば、base vocabulary はすべての pre-tokenize(事前トークン化)済みの語と、最も一般的な部分文字列(substrings)に対応し得ます。Unigram は transformers ライブラリ内のどのモデルにも直接は使われませんが、SentencePiece と組み合わせて使われます。
各訓練ステップで、Unigram アルゴリズムは現在の vocabulary と unigram 言語モデルに基づき、訓練データ上の loss 関数(損失関数。通常は log-likelihood として定義)を定めます。その後、vocabulary 内の各記号について、その記号を vocabulary から除去した場合に総 loss がどれだけ増えるかを計算します。Unigram はその後、 パーセント( は通常 10% または 20%)の、loss 増加が最も小さい記号、つまり訓練データ上の総 loss への影響が最も小さい記号を除去します。この過程は、vocabulary が望ましいサイズに達するまで繰り返されます。Unigram アルゴリズムは、あらゆる語を tokenize できるように、基礎文字(base characters)を常に保持します。
Unigram は merge rules(結合規則 — BPE と WordPiece とは対照的)に依拠しないため、訓練後の新しいテキストを tokenize する方法がいくつかあります。たとえば、訓練済み Unigram tokenizer が次のような vocabulary を持つとします。
["b", "g", "h", "n", "p", "s", "u", "ug", "un", "hug"]
語 "hugs" は ["hug", "s"]、["h", "ug", "s"]、または ["h", "u", "g", "s"] に tokenize できます。ではどれを選ぶべきでしょうか。Unigram は vocabulary に加えて、訓練データにおける各 token の確率も保存するため、起こり得るすべての tokenization の確率を訓練後に計算できます。実務では、アルゴリズムは通常、最も起こりやすい(most likely)tokenization を単純に選びますが、それらの確率に基づいて実行可能な tokenization をサンプリング(sample)する能力も提供します。
これらの確率は、tokenizer が訓練された loss 関数によって定義されます。訓練データが語 からなり、語 に対する可能なすべての tokenization の集合が と定義されるとすると、総損失 は次のように定義されます。
| 分析上の特徴 | Word-level | Character-level | Subword-level (BPE/WordPiece) |
|---|---|---|---|
| アルゴリズムの複雑さ | 非常に低い | 非常に低い | 高い(辞書の訓練段階が必要) |
| OOV リスクの水準 | 非常に高い(モデルを盲目にする) | 存在しない | 中程度から低い |
| 意味の保持 | 完全(各語が一つの概念) | 非常に悪い(無意味な文字) | 良い(語根を保持し、接尾辞を分離) |
| 系列長 | 短い | 極めて長い | 中程度(最適な均衡) |
| 推奨される応用 | 基本分析、狭い英語データ | DNA分析、遺伝子配列、綴り誤り | あらゆる LLM、機械翻訳の必須標準 |
3. Implementation
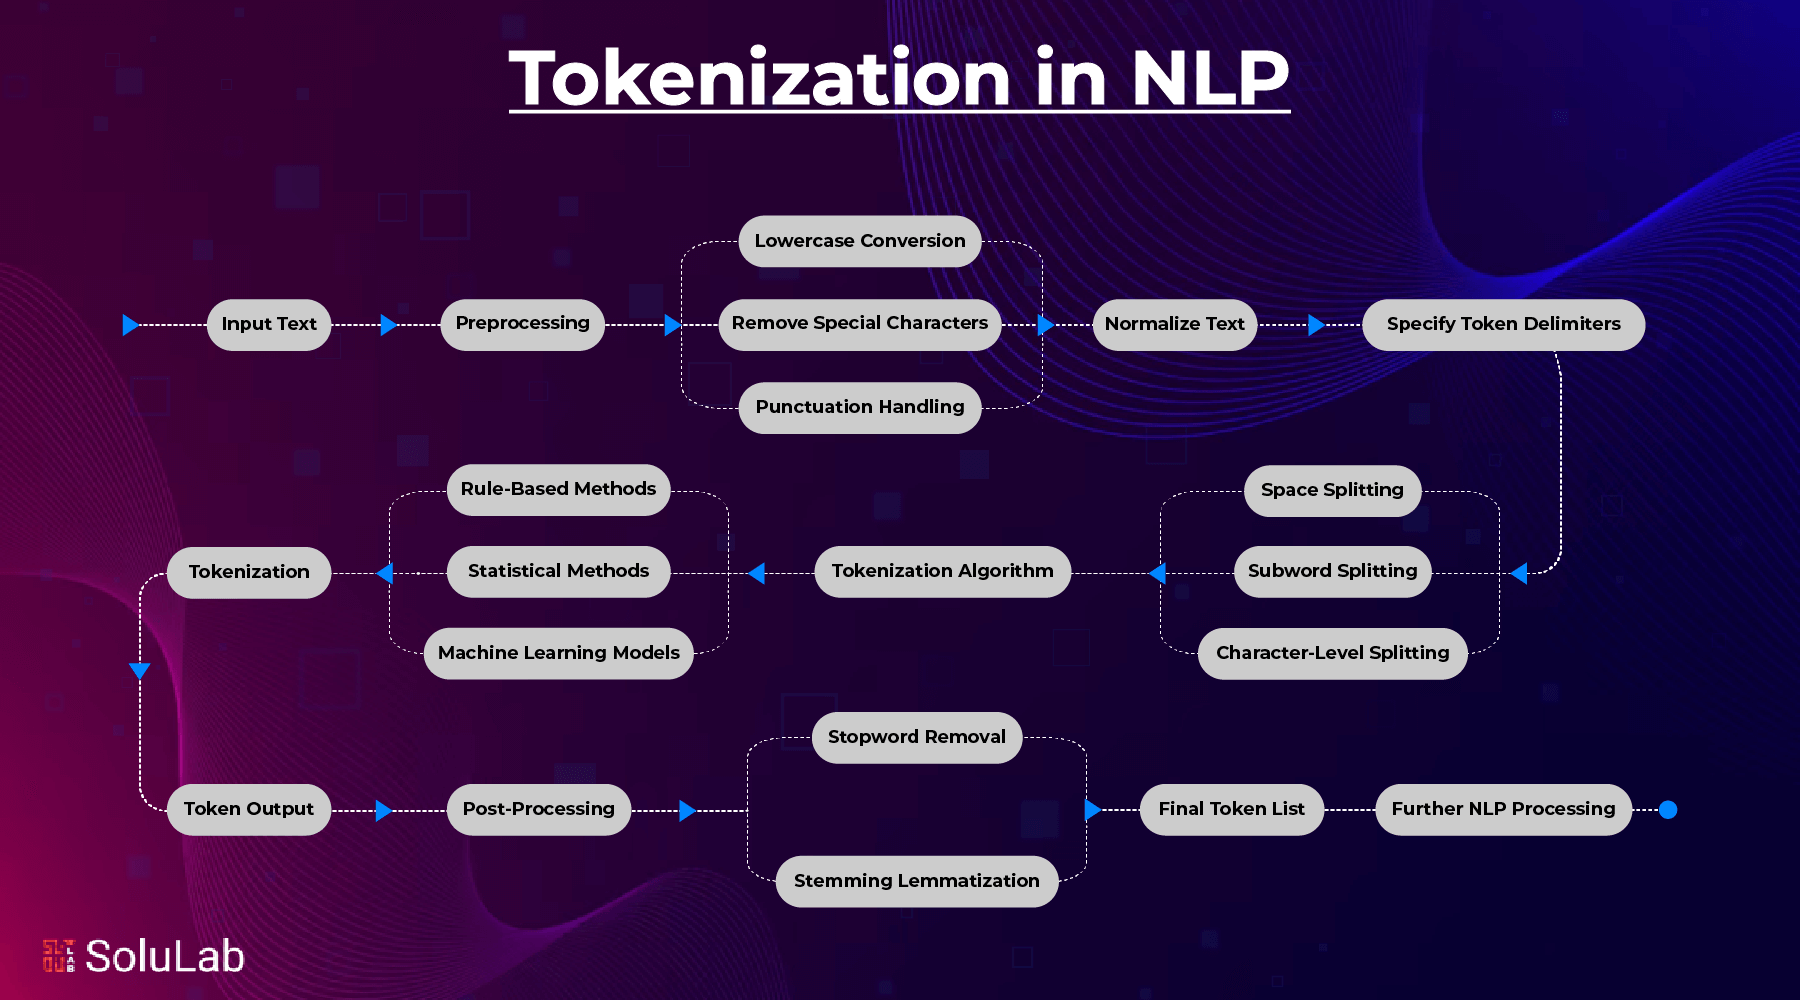
3.1. Basic Tokenization(英語向けの NLTK と SpaCy の利用)
中小規模の英語データ分析の文脈では、NLTK(Natural Language Toolkit)と spaCy は無視できない2つの金字塔です。それらは精緻な言語学的規則、空白の分解、例外処理の卓越した能力に基づいて動作します。
# 環境セットアップの手順:
# pip install nltk spacy
# spaCy 用の言語モデルのダウンロードが必要: python -m spacy download en_core_web_sm

import nltk
from nltk.tokenize import word_tokenize
import spacy

# NLTK の基本的な文分割リソースをダウンロード(一度だけ実行すればよい)
nltk.download('punkt', quiet=True)

def basic_english_tokenization(text: str):
    """
    NLTK と SpaCy による基本的な Tokenization を示す。
    目的: アルゴリズムが省略形、句読点、特殊記号をどう処理するかを観察する。
    """
    print(f"--- 入力テキスト(RAW TEXT) ---")
    print(f"{text}\n")

    # 1. NLTK Tokenization の実装
    # NLTK は基本的な機械学習モデル(Punkt)を使い、語と句読点の境界を認識する
    nltk_tokens = word_tokenize(text)
    print(f"--- NLTK TOKENIZATION の結果 ---")
    print(f"Token 総数: {len(nltk_tokens)}")
    print(f"Token 配列: {nltk_tokens}\n")

    # 2. SpaCy Tokenization の実装
    # SpaCy は包括的な構文解析を行い、コンパクトな英語言語モデルを読み込む
    nlp = spacy.load("en_core_web_sm")
    doc = nlp(text)

    # Doc オブジェクトから各 token の text 形式を抽出する
    spacy_tokens = [token.text for token in doc]

    print(f"--- SPACY TOKENIZATION の結果 ---")
    print(f"Token 総数: {len(spacy_tokens)}")
    print(f"Token 配列: {spacy_tokens}\n")

# 文法的な罠を含むテストシナリオ: 省略形(doesn't、O'Neill)、記号($)
sample_text = "Mr. O'Neill doesn't think the new AI model is worth $100.50!"
basic_english_tokenization(sample_text)
上のコードを実行すると、学習者は NLTK も spaCy も、通常の split() 関数をはるかに超える知性を示すことに気づくでしょう。
語 "doesn't" は、語根 "does" と否定接尾辞 "n't" へ正確に分解されます。これにより、後段のモデルは否定要素の存在を明確に認識できます。
記号 $ と ! は独立した token として分離され、次のデータクリーニング(data cleaning)ステップで容易に除去するか、金融的意味を持つ実体ラベルへ変換できます。
3.2. Underthesea によるベトナム語の複雑な前処理
形態的性格がまったく異なる言語へ転じます。ベトナム語です。ベトナム語は孤立語(isolating language)であり、空白は「語」(word / Linguistically Meaningful Unit)の境界を画定する役割ではなく、「音節」(syllable)を分離するためだけに使われます。英語向け NLTK の手法をベトナム語へ盲目的に適用すると、「thời gian」のような意味的に緊密な複合語は、「thời」と「gian」という2つの無意味な断片へ砕けます。
この障壁を徹底的に解決するには、ベトナム語コーパス上で専門的に訓練された単語分割器(Word Segmentation)を使うことが、必須の前処理ステップです。Underthesea は、Conditional Random Fields(CRF)に基づく強力な API を提供し、離散的な音節を完全な LMU へ結合する、第一級のオープンソースライブラリです。
# 環境セットアップの手順: pip install underthesea

from underthesea import word_tokenize

def vietnamese_word_segmentation(text: str):
    """
    ベトナム語で音節を意味的な語へ再構成する過程を示す。
    これは任意の Transformer モデルへ投入する前の必須前提である。
    """
    print(f"--- 生のベトナム語テキスト ---")
    print(f"{text}\n")

    # 単語分割を実行する。
    # パラメータ format="text" は、同じ語に属する音節を
    # アンダースコア(_)で自動結合し、切り離せない統一ブロックを作るよう設計されている。
    tokens_with_underscore = word_tokenize(text, format="text")

    print(f"--- 単語結合(WORD SEGMENTATION)の結果 ---")
    print(f"出力列: {tokens_with_underscore}")

vn_sample = "Tôi là sinh viên học tại trường đại học FPT Cần Thơ."
vietnamese_word_segmentation(vn_sample)
テキスト列は次のように変換されます。Tôi là sinh_viên học tại trường đại_học FPT Cần_Thơ.
音節を _ で固く結びつけることで、"sinh_viên"、"đại_học"、固有名詞 "Cần_Thơ" のような中核概念は意味的完全性を保たれます。この操作のおかげで、後段の BPE アルゴリズムは "sinh_viên" を統一ブロックとして認識し、文脈の誤学習を避けます。この技法は、実務における分類性能を高めるための生命線であることが検証されています。
3.3. Hugging Face による LLM 向け Modern Subword Tokenization
現代 Tokenization 技術の頂点は、Hugging Face の transformers ライブラリを通じて Subword 構造を運用することにあります。これはデータを LLM モデルへ送り込む門です。以下のコードは、英語 BERT モデル向け WordPiece システムと、ベトナム語 PhoBERT モデル向け BPE システムを実装し、それらの驚異的な語彙「細分化」メカニズムを明らかにします。
# 環境セットアップの手順: pip install transformers torch

from transformers import AutoTokenizer

def modern_subword_tokenization():
    """
    Transformer アーキテクチャで用いられる Subword レベルの Tokenization を実装する。
    識別子(Input IDs)の生成と接尾辞分割の現象を示す。
    """

    print("=== 1. BERT モデルの WORDPIECE システム(英語) ===\n")
    # Hugging Face のリポジトリから Tokenizer を初期化する
    bert_tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")
    en_text = "Transformers are revolutionizing natural language preprocessing!"

    # tokenizer() 関数はすべてのステップを自動実行する: クリーニング、部分語分割、ID 写像
    bert_output = bert_tokenizer(en_text)

    # 語がどう細かく切られたかを観察するため、ID を文字列形式へ逆変換する
    bert_tokens = bert_tokenizer.convert_ids_to_tokens(bert_output['input_ids'])

    print(f"生テキスト: {en_text}")
    print(f"Subword 一覧: {bert_tokens}")
    print(f"Input IDs ベクトル:   {bert_output['input_ids']}\n")


    print("=== 2. PHOBERT モデルの BPE システム(ベトナム語) ===\n")
    # PhoBERT は入力が事前に単語分割されていることを要求する(Underthesea または RDRSegmenter を使用)
    phobert_tokenizer = AutoTokenizer.from_pretrained("vinai/phobert-base")
    vn_text = "Tôi đang học về xử_lý ngôn_ngữ tự_nhiên."

    phobert_output = phobert_tokenizer(vn_text)
    phobert_tokens = phobert_tokenizer.convert_ids_to_tokens(phobert_output['input_ids'])

    print(f"元テキスト(結合済み): {vn_text}")
    print(f"Subword 一覧:   {phobert_tokens}")
    print(f"Input IDs ベクトル:     {phobert_output['input_ids']}")

modern_subword_tokenization()
BERT の場合: 学習者は WordPiece の魔法を目の当たりにします。"revolutionizing" のような長く複雑な語は、2つの断片 ["revolution", "##izing"] へきれいに切られます。語 "preprocessing" は ["pre", "##processing"] になります。記号 ## は、この断片が継続成分であり、直前の語根と結合して完全な語を作る必要があるとシステムが示す指標です。加えて BERT は、系列境界を示すために文頭の [CLS] と文末の [SEP] のような構造誘導 token を自動挿入します。
PhoBERT の場合: BPE アルゴリズムは、すでに正規化されたベトナム語列を分解します。結果は xử_lý、ngôn_ngữ のような複合語が完全に符号化されていることを示します。違いは、PhoBERT が入力構造の流れを管理するために [CLS] と [SEP] ではなく <s> と </s> タグを使うことです。これらの誘導記号の違いを掌握することは、すべての NLP エンジニアの生存技能です。
4. 正規化の技術と前処理戦略
Tokenization システムの設計は、ライブラリから数行のコマンドを呼び出すことでは終わりません。これはデジタル思考と深い言語学的知識が交錯する技術です。ソーシャルメディア、フォーラム、非構造化テキストからの混沌に満ちた実データ環境では、経験豊富なエンジニアは、データがニューラルネットワークの門に達する前に、多数のノイズの罠に直面し、解決しなければなりません。
4.1. テキストのクリーニングと正規化の技法(Text Normalization)
データクリーニング過程は、辞書の純度を決定づける役割を果たします。インターネットからの生データ(Non-Standard Words - NSW)は、アルゴリズムのあらゆる深層学習の努力を崩壊させ得る無数の非標準変異を含みます。
まず、余分な空白とデジタルノイズへの対処です。テキストはしばしば無意味なタブ文字、空行、余分なスペースで詰め込まれます。それらを掃除しなければ、空 token の爆発を招き、情報を希釈し、系列長を不必要に増やします。専門的な推奨は、Clean-text のようなライブラリや正規表現(Regex)を使い、テキスト空間を平坦化・正規化することです。同様に、ハイパーリンク(URLs)、HTML タグ、メールアドレスは意味的価値に寄与することはまれですが、辞書を深刻に汚染します。エンジニアはそれらを積極的にフィルタするか、一意の認識 token(例: <URL>、<EMAIL>)で置き換える必要があります。
次は 大文字/小文字(Casing) の処理技術です。大文字と小文字の区別の不一致は、識別子表現における大規模な重複を引き起こします。たとえば "Good"、"good"、"GOOD" は、システムによってまったく別の3つの概念として理解され、モデルの統計的力を分散させ、感情理解の能力を妨げます。ここでの決定は、課題の目標に密接に依存します。Named Entity Recognition(NER)システムを構築するなら、大文字は固有名 "Apple"(企業)と普通名詞 "apple"(りんご)を区別するための生命線となる手がかりです。しかし感情分析では、重要な情報を損なわずに辞書サイズを圧縮し学習を最適化するため、テキスト全体を小文字(lowercase)へ変換するのが最も賢明な戦略です。
もう一つの現代的な挑戦が 絵文字(Emoji)と特殊句読点 です。現代のデジタルコミュニケーション言語では、一つの絵文字が数十語を組み合わせた以上の感情表現力を持ちます。顧客フィードバック分析で Regex を使って絵文字を一掃することは致命的な誤りです。代わりに専門家は2つの解決策を推奨します。Tokenizer が Unicode 符号化を復号する仕組みを持ち、絵文字を高い価値を持つ独立 token として保護すること、または(Python の emoji ライブラリのような)変換器を使い、それらをテキスト形式(例: 怒った顔の絵文字を [angry_face])へ変換してモデルが吸収しやすくすることです。同様に句読点について、ピリオドの列 ... や感嘆符 !!! は皮肉や高まる感情の明確な指標であり、直前の語にくっつけるのではなく、独立した意味単位として tokenization する必要があります。
ベトナムでは、組織やエンジニアはしばしば国内向けの専門正規化ツールを活用しなければなりません。VietNormalizer のようなライブラリは、整数、日付、通貨(VND、USD)の変換と、略語を標準的な発音形式へ復号する能力をもたらします。この過程は、ソーシャルメディア言語の無限の変異を縮小するだけでなく、Text-to-Speech と大規模言語モデル NLP の双方に、清潔で厳密に構造化されたデータを供給します。
4.2. 各言語グループ向け戦略の選択基準
万能("one-size-fits-all")な Tokenizer アルゴリズムは存在しません。言語グループ間の形態類型(morphological typology)の違いは、ツール選択を直接決定します。機能の合わないツールを無理に使うことは、機械学習アーキテクチャの破壊という結果を招きます。
空白が語を区切る言語グループ(英語、インド・ヨーロッパ語族):
語境界がスペースによってすでに透明に引かれているため、専門家は生データへ直接 Subword モデル(BPE、WordPiece、SentencePiece)を展開できます。それでも、subword tokenizer へ入れる前に NLTK や SpaCy で "don't" や "I'm" のような短縮形を知的に分解する前処理層は、データの純度を保つ標準的実践です。
空白なしで続く言語グループ(中国語、日本語、韓国語):
これらの言語の構造には空白が完全に欠けており、スペースに基づく tokenization のあらゆる努力は無意味になります。ここでの解決策は、言語辞書を統合した複雑な形態解析器(Morphological Analyzers)を緊密に組み合わせることです。これらのシステムは統計的確率を計算し、最も妥当な単語切断境界を見つけます。現代 LLM で強く用いられるもう一つのアプローチは、これらの言語では Character-level Tokenization へ退行し、より長い系列長を受け入れて意味の喪失がないことを保証することです。
音節境界を持つ孤立語グループ(ベトナム語):
ベトナム語は独自の特徴を持ちます。単音節言語でありながら、語彙の大部分は複合語です。空白は存在しますが、語境界(LMU)ではなく音節を分離する役割しか持ちません。生のベトナム語テキストを BPE モデルへ直接入れることは、言語学的構造を破壊する行為です。
The Ultimate Pipeline: ベトナムの NLP エンジニアは、2段階からなる過程を厳格に守らなければなりません。第1段階では、テキストは機械学習に基づく単語分割ツールで処理されなければなりません。
RDRSegmenter(Ripple Down Rules アルゴリズムに基づき、VnCoreNLP および PhoBERT システムでしばしば推奨される)、またはUnderthesea(標準データセットで最大 80% の精度に達する CRF アーキテクチャを使用)、あるいはpyviのような軽量パッケージを選べます。この過程は関連する音節をアンダースコアで溶接します("chăm sóc" は "chăm_sóc" になります)。第2段階へ進むと、このすでに構造化されたデータ系列が初めて Subword アルゴリズム(PhoBERT の fastBPE など)へ正式に投入されます。この二層の組み合わせは、ベトナム語の課題を解くあらゆる NLP モデルに卓越した性能をもたらす中核要因であることが実験的に証明されています。
5. Tokenization の実践的影響を分析するケーススタディ
抽象的理論は、実際の数字によって証明される必要があります。以下の2つの状況分析(Case Study)は、Tokenization 戦略の正誤の選択が、人工知能プロジェクトの経済と性能の局面を完全に逆転させ得るという事実を明らかにします。
シナリオ 1: 多言語 LLM を訓練するときのコストと性能の悲劇
システムの文脈: グローバルな AI 開発競争のなかで、ある研究連合は 2.6 億パラメータ規模の Transformer アーキテクチャ LLM モデル 24 個を大規模訓練し、多言語へのサービスを目指しました。進捗を加速し設計労力を節約するため、チームは英語向けにすでに最適化された Tokenizer(English-centric tokenizer)を直接再利用して他のすべての言語を訓練すると決め、BPE アルゴリズムが周辺言語の構造を自動的に汎化し「学習」できることを望みました。
誤った選択の経緯と帰結: 英語の形態構造を優先する Tokenizer を、かけ離れた言語体系へ強制することは、包括的なシステム災害に火をつけました。
中核能力の劣化(Downstream Performance Degradation): 形態が複雑、または英語から大きく異なる言語(ベトナム語、ロシア語、ギリシャ語など)は残酷に断片化されました。完全な意味を持つ語を認識する代わりに、英語 Tokenizer はこれらの言語の語彙を 5 から 7 個の離散的で無意味な文字 token へ細かく砕きました。この断裂は Transformer ネットワーク内部の Attention(注意)メカニズムを麻痺させ、モデルは文脈をつなぎ、論理推論を行ううえで完全に方向を失いました。
訓練コストの爆発(Training Costs Explosion): 語彙を砕く現象は、情報単位あたりの token 密度を直接急増させます(研究者が肥沃度 — fertility — と呼ぶ指標)。単純な文が表現に何十もの token を消費すると、モデルの限られた文脈長(context length)は急速に埋まります。報告された最も恐ろしい帰結は、計算コストが最大 68% 急増したことです。高価な GPU クラスタ上の何万時間もの処理時間が、前処理パイプラインが作り出した不合理な語彙を消化するためだけに浪費されました。
マクロなアーキテクチャ上の解決策: この災害から、専門家は次の法則を抽出しました。Tokenizer は中立な構成要素ではありません。調査は、ヨーロッパ最大の5言語向け Tokenizer を設計するだけでも、完全性(parity)を維持するには語彙サイズが英語のみのモデルの3倍に膨張しなければならないことを示しています。ベトナム語やギリシャ語のような低資源言語では、現地化された Tokenizer を構築するか、ラベルなしの非符号化アーキテクチャ(T-Free モデルなど)を使うための予算配分が、巨大テック企業との差を縮める生存条件です。
シナリオ 2: 小売業におけるフィードバック感情の解読戦略
システムの文脈: ポルトガルの大規模小売グループがベトナム市場へ拡大するなか、経営陣はソーシャルメディアと電子商取引プラットフォーム上の数十万件の顧客コメントから経済的価値を引き出すために機械学習を応用したいと考えました。正確な感情分析(Sentiment Analysis)は、製品戦略の調整、広報危機の予防、市場ポジショニングを決定します。
実験と生死を分ける決定:
ノイズの高い典型的な顧客フィードバックを考えます。"Sản phẩm này giá không rẻ, nhưng dịch vụ chăm sóc khách hàng cực kỳ tốt."
従来の Word-level Tokenization の失敗: 最初の試みで、データチームは split() 関数による基本的な分解とストップワード(stopwords)の除去を使いました。システムは文を次の配列へ引き裂きました。 *['Sản', 'phẩm', 'này', 'giá', 'không', 'rẻ', ',', 'nhưng', 'dịch', 'vụ', 'chăm', 'sóc', 'khách', 'hàng', 'cực', 'kỳ', 'tốt']*。後続の Bag-of-Words または TF-IDF アルゴリズムは、"rẻ" と "tốt" を孤立した実体として受け取り、一方で生命線となる否定要素 "không" は捨てられるか、"rẻ" と結びつけられない危険がありました。結果は? 素朴な分類モデルはフィードバック全体を価格政策とサービス双方に対して Positive(肯定) と評価し、価格部門を危険な戦略的罠へ押しやりました。
結合前処理アーキテクチャ(Segmentation + BERT)の台頭: 急所を認識し、彼らは精緻な Tokenization 戦略を適用しました。まずデータのクリーニングとテキストの normalize から始め、その後 Underthesea の単語分割ツールを使います。句は緊密な意味構造を持つ LMU へ統合されます。không_rẻ、chăm_sóc、khách_hàng、cực_kỳ。最後に、この配列は BERT モデルの WordPiece アルゴリズムへ送られます。このとき、正しい意味ブロックへまとめられたデータと組み合わせた BERT の Attention メカニズムは、価格の Negative(否定) の色合い(không_rẻ)とサービスの Positive(肯定) の色合いを容易に識別し、分離しました。
経済的・技術的成果: データの形態構造の法則を尊重する Tokenization 戦略を設計したことは、システムを完全に転換しました。製品レビューデータセット上の類似アルゴリズム評価研究では、最適化された語彙と組み合わせた BERT アーキテクチャが古典的モデル(Logistic Regression や SVM など)を圧倒し、94.2% という非凡な正解率(Accuracy)と、0.97 に近づくほぼ完全な AUC-ROC を確立しました。構成指標を深く分析すると、よく Tokenize されたシステムは適合率(Precision)と再現率(Recall)の鋭い均衡をもたらし、F1 Score を、顧客サービスフローを完全に自動化できる信頼閾値まで押し上げました。
中核モデル訓練の水準と商業応用の水準という2つの実践的断面を通じて、全体像は生き生きと描かれました。テキスト断片の分割は一見すると控えめな前処理操作に見えますが、それが生み出す波紋(ripple effects)は、認知システムの洗練を決定し、数百万ドルのサーバーインフラコスト配分の効率を決め、データ市場における企業の中核的競争力を形づくる力を持ちます。Tokenization の技術を掌握することは、プログラミングコードの断片を理解することだけでなく、人類がコミュニケーションする方法と人工知能が思考する方法への深い理解を開く鍵なのです。
参考文献
Summary of the tokenizers, https://huggingface.co/docs/transformers/v4.44.1/en/tokenizer_summary
執筆 Huỳnh Phước Nguyên
AIエンジニア、BK Hightech